Marigold V2 повысил точность оценки глубины на 16-26%
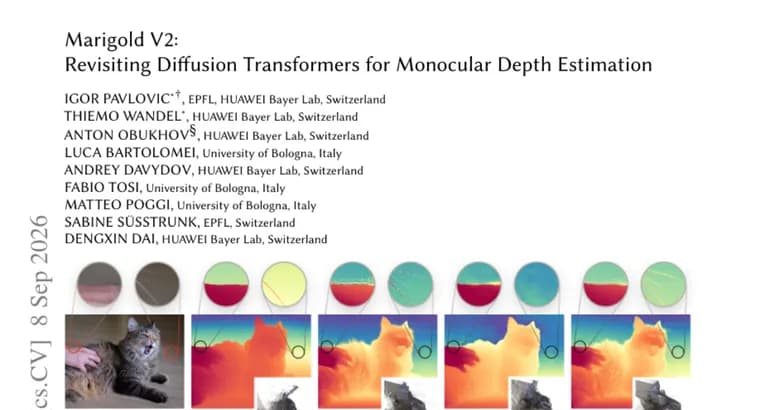
Оценка глубины по одному снимку, повсеместно применяемая, но принципиально некорректно поставленная (ill-posed) задача компьютерного зрения: её результаты используются в 3D-реконструкции сцен, компьютерной фотографии, робототехнике и других задачах. По словам авторов, несмотря на зрелость направления, современные модели всё ещё плохо переносятся на данные вне обучающего распределения (out-of-distribution) и выдают недостаточно чёткие, детализированные карты глубины.
Новая работа возвращается к технике Marigold, набору приёмов, которые превращают современные модели генерации и редактирования изображений на основе архитектуры диффузионных трансформеров (DiT) в передовые оценщики глубины по одному кадру, и представляет её обновление, Marigold V2. Ключевая идея новых рецептов, перевести модель на однократный инференс вместо многошагового процесса, на котором обычно работают предобученные модели класса flow matching, и там, где нужно, применить квантизацию, вместе это должно сохранить возможности модели и сделать её инференс дешёвым. Разобрав, какие артефакты возникают при обучении такой схемы «в лоб», авторы предложили два эффективных исправления: согласовать внутренние представления модели с семантическими признаками, извлечёнными из эталонных (ground-truth) данных, и использовать двухэтапный протокол дообучения, построенный вокруг новой функции потерь на основе алгоритма Синкхорна.
В результате карты глубины получаются более чёткими и аккуратными, а также лучше обобщаются на нетипичные для обучения снимки: на бенчмарках KITTI и ETH3D показатель AbsRel (средняя относительная ошибка между предсказанной и истинной глубиной) улучшился на 16-26% по сравнению с лучшими из прежних моделей, какие именно модели брались для сравнения и какими были абсолютные значения метрики, авторы не указывают, приведена только величина улучшения. Качественно Marigold V2 научился чётко прорисовывать детали, которые не давались прежним моделям: шерсть, листву и тонкие, как волос, границы объектов. По утверждению авторов, модель показывает передовые результаты и на других задачах плотной регрессии, например, оценке нормалей поверхности (направления, в которые «смотрит» каждая точка поверхности) и разложении изображения на внутренние составляющие вроде цвета поверхности и освещения (intrinsic image decomposition).
Ключевые факты
- Marigold V2 переводит диффузионные модели генерации изображений (архитектура DiT) на однократный инференс глубины по одному снимку вместо многошагового процесса flow matching, применяя квантизацию там, где нужно, чтобы инференс оставался дешёвым.
- Артефакты наивного обучения авторы устранили двумя способами: согласованием внутренних представлений модели с эталонными семантическими признаками и двухэтапным дообучением с новой функцией потерь на основе алгоритма Синкхорна.
- На бенчмарках KITTI и ETH3D показатель AbsRel улучшился на 16-26% относительно лучших из прежних моделей; конкретные модели сравнения и абсолютные цифры в тексте не названы.
- Модель научилась чётко прорисовывать шерсть, листву и тонкие, как волос, границы объектов, детали, которые не давались прежним подходам.
- По словам авторов, Marigold V2 показывает передовые результаты и на смежных задачах: оценке нормалей поверхности и разложении изображения на внутренние составляющие (intrinsic image decomposition).
Почему это важно
Оценка глубины по одному снимку, фундаментальный строительный блок для 3D-реконструкции сцен, компьютерной фотографии и робототехники, но задача принципиально некорректно поставлена: по одному кадру нельзя однозначно восстановить трёхмерную геометрию сцены. По словам авторов, даже зрелые современные модели этой области всё ещё плохо переносятся на данные вне обучающего распределения и выдают недостаточно детализированные карты глубины. Marigold V2 продолжает линию, которая приспосабливает уже готовые диффузионные модели генерации изображений (архитектура DiT) под задачу оценки глубины вместо обучения отдельного оценщика с нуля, и одновременно закрывает практический разрыв, переводит инференс с многошагового диффузионного процесса на один шаг, стараясь сохранить точность и одновременно резко снизить его стоимость.
Кому это важно
Инженерам и исследователям компьютерного зрения, которые строят пайплайны 3D-реконструкции сцен, компьютерной фотографии и робототехники, сферы применения, прямо названные в тексте. Тем, кому нужен не только точный, но и дешёвый, быстрый инференс: однократный проход вместо многошагового диффузионного процесса снижает вычислительную стоимость запуска модели. Командам, которым помимо глубины нужны смежные плотные регрессионные оценки, нормали поверхности или разложение изображения на составляющие вроде цвета и освещения, по утверждению авторов, тот же рецепт показывает передовые результаты и на этих задачах.
Как это применить
В тексте не сказано, опубликован ли код или веса модели, прямо указан только отдельный сайт проекта с демонстрацией на Hugging Face Spaces. Сам рецепт, однако, можно перенимать независимо от конкретной реализации: перевод предобученной диффузионной модели генерации изображений (архитектура DiT, обучение по схеме flow matching) на однократный инференс, с квантизацией там, где нужно; согласование внутренних представлений модели с семантическими признаками эталонных данных; двухэтапное дообучение с функцией потерь на основе алгоритма Синкхорна для устранения артефактов наивного обучения. По данным авторов, этот же рецепт годится не только для оценки глубины, но и для других задач плотной регрессии, оценки нормалей поверхности и разложения изображения на внутренние составляющие.
Можно ли доверять
Источник, карточка препринта на Hugging Face Papers, текст доступен в виде аннотации (abstract). В ней не названы ни авторы, ни организации-разработчики, установить их по одной аннотации нельзя. Главный заявленный результат, улучшение AbsRel на 16-26% на бенчмарках KITTI и ETH3D, дан только как относительная величина: абсолютные значения метрики и конкретные модели, с которыми идёт сравнение («лучшие из прежних»), в тексте не названы, поэтому независимо оценить реальный масштаб улучшения по одной аннотации нельзя. Утверждения о передовых результатах в смежных задачах, оценке нормалей поверхности и разложении изображения на составляющие, тоже поданы только как заявление самих авторов, без чисел и без указания, с чем именно сравнивали.
Риски и подводные камни
Ключевое ограничение, отсутствие абсолютных цифр и названных базовых моделей: заявленные 16-26% ничего не говорят о том, насколько высок или низок сам итоговый уровень точности. Сама задача в принципе некорректно поставлена (ill-posed), оценка глубины по одному кадру всегда остаётся приближением, и никакая архитектура не снимает эту неоднозначность полностью. Авторы утверждают, что квантизация и переход на однократный инференс «сохраняют возможности модели», но не приводят цифр, которые показывали бы, во что именно обходится этот переход по сравнению с исходным многошаговым инференсом. В тексте также нет данных о стоимости обучения, требованиях к оборудованию, дате публикации и о том, будут ли открыты код или веса модели, без этого повторить или независимо проверить результат нельзя.