MaP-WAM: фреймворк «память как план» для роботов показал рекорд на RMBench
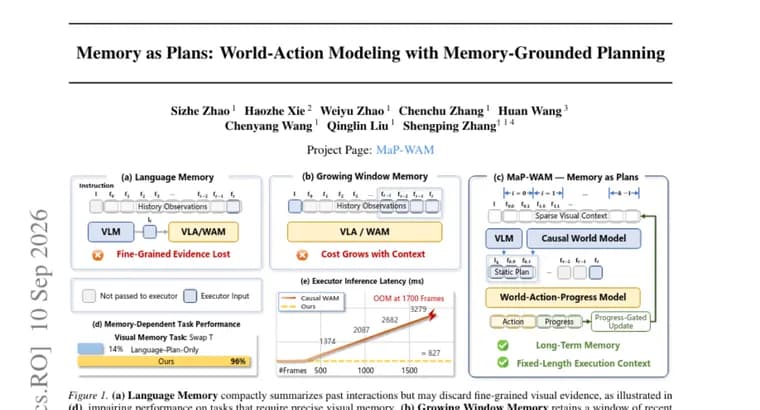
Большинство современных стратегий управления роботами-манипуляторами устроены марковски: решение о следующем действии принимается только по текущему наблюдению, без учёта того, что происходило раньше. Авторы отмечают, что многие сложные задачи манипуляции в реальном мире по своей природе немарковские и требуют памяти на большом горизонте, то есть модели нужно опираться не только на то, что видно прямо сейчас, но и на события, случившиеся раньше в том же эпизоде. Существующие способы дать модели такую память, текстовые сводки истории, постоянно растущее окно визуальных кадров или их сочетание, по словам авторов, могут терять мелкие визуальные детали при сжатии в текст либо вынуждают выбирать между тем, сколько истории охватывает модель, и тем, насколько быстро она при этом работает.
Чтобы решить это противоречие, авторы предлагают MaP-WAM (от английского Memory-as-Plans, «память как планы»), фреймворк, который разбивает построение зависящей от памяти модели мира и действий на два отдельных этапа: планирование, опирающееся на память, и исполнение, подчинённое плану. Вместо того чтобы на каждом шаге заново подавать модели, исполняющей действия, всю накопленную историю целиком, MaP-WAM использует длинный мультимодальный эпизодический контекст (память) только как опору на этапе планирования, а исполнению передаётся уже готовый компактный план.
Память в MaP-WAM устроена как набор записей уже завершённых сегментов задачи: каждая запись хранит языковую инструкцию этого сегмента вместе с разреженным (неполным, отобранным) визуальным контекстом из него. Эту эпизодическую память фреймворк переводит в компактный план, языковую инструкцию для следующего сегмента и соответствующую ей визуальную подсказку. Иначе говоря, вместо повторного просмотра всей истории целиком система один раз сжимает уже сделанное в короткую инструкцию о том, что делать дальше.
Само исполнение плана выполняет отдельный компонент, модель World-Action-Progress (WAP, «мир-действие-прогресс»). Поскольку заранее не известно, сколько шагов займёт выполнение конкретного плана, WAP на каждом шаге вывода одновременно предсказывает и блоки действий робота, и то, насколько выполнение плана уже продвинулось (прогресс). Предсказанный прогресс калибруется сверкой плана с фактическим наблюдением, это и позволяет системе адаптивно решать, когда один сегмент плана закончен и пора переходить к следующему, и обновлять рабочий контекст по принципу обратной связи (замкнутого цикла) по ходу выполнения.
Поскольку исполнитель работает с компактным планом, а не с историей целиком, длина его контекста остаётся фиксированной независимо от того, насколько длинной становится история задачи. Дополнительно структурированное внимание позволяет кэшировать ключи и значения (KV-кэш) и на этапе планирования, и на этапе исполнения, что удешевляет вычисления по мере роста истории.
На бенчмарке RMBench (в тексте он не расшифровывается и не описывается) MaP-WAM показал, по формулировке авторов, рекордный на сегодня результат, 83,3% успешных попыток; в экспериментах на реальном роботе успешность составила 78,0%. При этом благодаря фиксированной длине контекста исполнителя задержка вывода у него остаётся примерно постоянной даже при росте истории задачи, то есть на длинных задачах система не начинает заметно замедляться.
Ключевые факты
- Проблема: типичные стратегии роботов-манипуляторов марковские, решают только по текущему кадру, а многие задачи манипуляции по своей природе немарковские и требуют памяти на длинном горизонте; текстовые сводки истории и растущие визуальные окна теряют детали или замедляют исполнение.
- Решение, фреймворк MaP-WAM (Memory-as-Plans): память хранится как записи завершённых сегментов (языковая инструкция + разреженный визуальный контекст) и на этапе планирования сжимается в компактный план для следующего сегмента, а не подаётся исполнителю целиком на каждом шаге.
- Исполнение плана ведёт модель World-Action-Progress (WAP): она одновременно предсказывает блоки действий и прогресс их выполнения, калибрует прогресс сверкой плана с наблюдением и по этой калибровке адаптивно переключает сегменты и обновляет контекст.
- Длина контекста исполнителя фиксирована независимо от роста истории задачи; структурированное внимание даёт кэширование ключей и значений (KV-кэш) на планировании и на исполнении.
- Результаты: 83,3% успешных попыток на бенчмарке RMBench (рекордный результат, по словам авторов) и 78,0%, в экспериментах на реальном роботе; задержка вывода исполнителя остаётся примерно постоянной даже при росте истории задачи.
Почему это важно
Ключевое ограничение сегодняшних стратегий управления роботами-манипуляторами в том, что они смотрят только на текущий кадр и плохо справляются с задачами, где важно опираться на события, случившиеся раньше в этом же эпизоде. Раньше добавить такую память можно было либо ценой потери мелких визуальных деталей, при сжатии истории в текстовую сводку, либо ценой скорости: чем длиннее история, тем дороже становится каждый следующий шаг исполнения. MaP-WAM показывает, что разделение памяти на этап планирования и этап исполнения снимает это противоречие, исполнитель работает с компактным планом фиксированного размера, а не с растущей историей целиком, поэтому память не должна дорожать с каждым новым шагом задачи.
Кому это важно
В первую очередь, исследователям и инженерам, которые строят стратегии управления роботами-манипуляторами и модели мира для робототехники: тем, кто работает с задачами на длинном горизонте планирования, где важна память о давних шагах эпизода, командам, которые упираются в рост вычислительных затрат при увеличении истории задачи, и разработчикам архитектур с разделением планирования и исполнения для агентов, управляющих физическими роботами.
Как это применить
MaP-WAM, исследовательский фреймворк, а не готовый продукт: применить его напрямую можно, только воспроизведя архитектуру по статье. Схема из текста: память представляется как записи завершённых сегментов задачи (языковая инструкция плюс разреженный визуальный контекст), эти записи сжимаются в компактный план для следующего сегмента, а отдельная модель World-Action-Progress исполняет план, одновременно предсказывая действия и прогресс их выполнения. Ключевое инженерное следствие, длина контекста исполнителя не растёт вместе с историей задачи, что должно упрощать развёртывание на более длинных и сложных сценариях манипуляции. Оговорка: в тексте не сказано, будут ли опубликованы код, веса модели или датасет, без этого воспроизвести и опробовать метод самостоятельно нельзя, остаётся только дожидаться публикации реализации или читать полный текст статьи.
Можно ли доверять
Материал, аннотация научной статьи на HuggingFace Papers; в самом тексте не названы ни авторы, ни организации, ни дата публикации (поле «автор» в карточке, служебная метка HuggingFace, а не подпись в тексте статьи). Цифры 83,3% и 78,0%, это собственные, ничем не сверенные извне результаты авторов: в тексте нет ни предыдущего лучшего результата, ни названия метода-конкурента, с которым сравнивают производительность, ни описания самого бенчмарка RMBench, ни деталей экспериментов на реальном роботе (какой робот, какие задачи, сколько попыток). Судить по одной аннотации, насколько заявленное превосходство реально и воспроизводимо, нельзя, для этого нужны полный текст статьи, таблицы сравнения и, в идеале, независимое воспроизведение.
Риски и подводные камни
Главный источник неопределённости, сам бенчмарк RMBench: в тексте он не описан и не расшифрован, поэтому непонятно, насколько он представителен для реальных задач манипуляции и насколько сложны его сценарии. Подход завязан на корректное разбиение эпизода на сегменты и на точную калибровку прогресса моделью WAP: если оценка прогресса собьётся, адаптивный переход между сегментами может произойти слишком рано или слишком поздно, а в тексте не описано, как система ведёт себя в таком случае. Детали экспериментов на реальном роботе, тип робота, состав задач, число попыток, не приведены, поэтому 78,0% успеха сложно оценить в контексте: неизвестно, насколько разнообразными и сложными были эти задачи. Наконец, в тексте нет ни слова о публикации кода, весов модели или датасета, так что независимая проверка результатов пока невозможна.