Исследователи предложили самообучение языковых моделей без размеченных данных
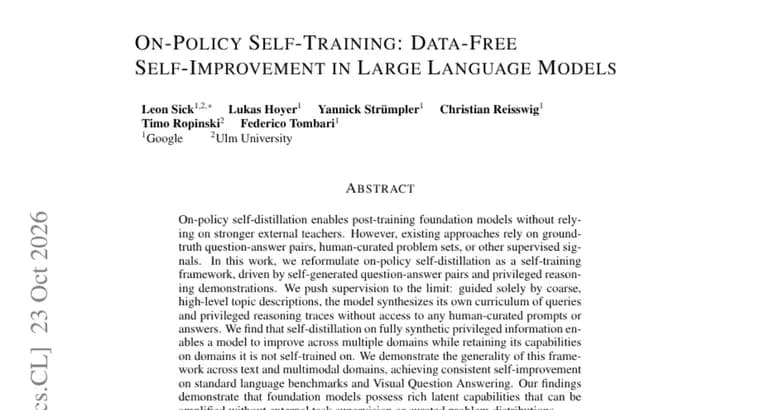
В статье на Hugging Face Papers предложен способ дообучать базовые модели (foundation models) без внешних учителей и без размеченных людьми данных. Исходная точка, on-policy self-distillation (самодистилляция на собственных ответах модели): она позволяет доводить модель после предобучения без опоры на более сильную внешнюю модель-учителя. Однако, как отмечают авторы, существующие подходы всё равно опираются на пары «вопрос, верный ответ», подобранные людьми наборы задач или другие контролирующие сигналы.
Авторы переформулируют самодистилляцию как фреймворк самообучения (self-training), который строится на самостоятельно сгенерированных парах «вопрос, ответ» и привилегированных демонстрациях рассуждений (privileged reasoning demonstrations). Контроль сведён к минимуму: единственное, что получает модель, грубые, общие описания тем. По ним она сама синтезирует собственную программу обучения: набор запросов и привилегированных цепочек рассуждений, не обращаясь ни к каким подготовленным людьми запросам или ответам.
Главный результат, по словам авторов: самодистилляция на полностью синтетической привилегированной информации позволяет модели улучшаться сразу в нескольких областях и при этом сохранять возможности в тех областях, на которых она не самообучалась. Универсальность подхода показана на текстовых и мультимодальных задачах: авторы заявляют о стабильном самоулучшении на стандартных языковых бенчмарках и в Visual Question Answering (ответы на вопросы по изображениям).
Итоговый вывод авторов: у базовых моделей есть богатые скрытые способности, которые можно усилить без внешнего контроля по задачам и без заранее подобранных распределений задач. В доступном описании не названы модели, бенчмарки и величина улучшений, поэтому масштаб эффекта по нему оценить нельзя.
Ключевые факты
- Метод: on-policy self-distillation переформулирован как самообучение на собственных парах «вопрос, ответ» и привилегированных цепочках рассуждений.
- Человеческие данные не нужны: модели дают только грубые общие описания тем, остальную учебную программу она синтезирует сама.
- По заявлению авторов, модель улучшается в нескольких областях и сохраняет способности в областях, на которых не самообучалась.
- Подход показан на текстовых и мультимодальных задачах: языковые бенчмарки и Visual Question Answering.
- В описании нет названий моделей, бенчмарков и величины прироста, только формулировка о «стабильном самоулучшении».
Почему это важно
Дообучение моделей обычно упирается в дорогие данные: подобранные людьми задачи, пары «вопрос, ответ» или более сильный учитель. Работа утверждает, что для самоулучшения хватает общих описаний тем, а всё остальное модель порождает сама. Если это подтвердится на практике, порог для дообучения снизится. Пока это заявление авторов, подкреплённое лишь общими формулировками.
Кому это важно
Исследователям пост-обучения и самодистилляции, командам, которые дообучают модели без доступа к размеченным данным или сильному учителю, а также тем, кто работает с мультимодальными моделями, поскольку подход заявлен и для визуальных вопросов-ответов.
Как это применить
По имеющемуся описанию практических шагов не сформулировать: о коде, наборах данных и релизе моделей в нём не говорится. Идею можно держать в уме как направление: задать модели общие темы, дать ей сгенерировать вопросы и рассуждения и дистиллировать их в себя. Для воспроизведения нужен полный текст статьи.
Можно ли доверять
Источник, краткое описание препринта на Hugging Face Papers; в нём не названы ни модели, ни бенчмарки, ни величина улучшений, ни сравнение с базовыми методами. Все выводы, это утверждения самих авторов. Независимой проверки в материале нет, поэтому оценивать силу результата рано.
Риски и подводные камни
Из описания неясно, на скольких областях и каких темах проверялся метод, насколько велик эффект и есть ли случаи, где он не работает: ограничения в нём не описаны. Заявление о сохранении способностей вне областей самообучения тоже нужно проверять по полному тексту. Обучение на собственных синтетических данных в принципе требует проверки, но конкретных рисков источник не называет.