Исследователи превратили детектор ИИ-текстов в прозрачный классификатор на разреженных автоэнкодерах
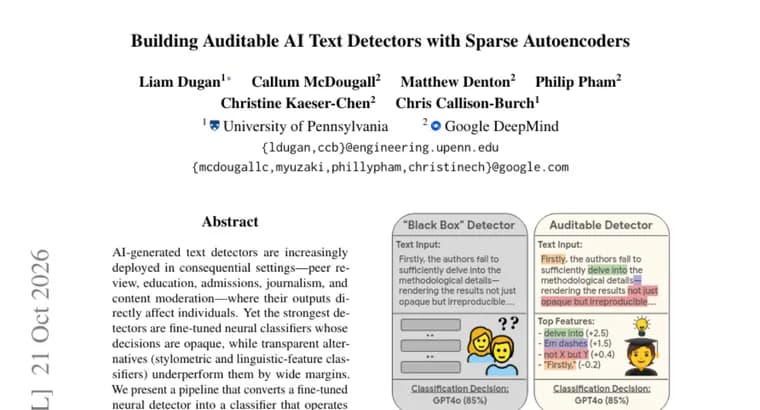
Авторы препринта исходят из проблемы: детекторы текстов, написанных ИИ, всё чаще применяют там, где их вердикт напрямую влияет на людей, в рецензировании научных работ, образовании, приёмных комиссиях, журналистике и модерации контента. При этом самые сильные детекторы, дообученные нейросетевые классификаторы, чьи решения непрозрачны. Прозрачные альтернативы (классификаторы на стилометрических и лингвистических признаках) уступают им с большим отрывом.
Авторы предлагают конвейер, который превращает дообученный нейросетевой детектор в классификатор, работающий с понятными человеку концептами. Шаги такие: сначала разреженные автоэнкодеры (sparse autoencoders, SAE) обучают прямо на residual stream (остаточном потоке) детектора; затем каждому признаку SAE автоматически присваивают описание (auto-interpretation); после этого оставляют только признаки, чьи сгенерированные описания проходят глобальный порог достоверности (fidelity threshold). Наконец, на одних лишь интерпретируемых признаках обучают лёгкий классификатор.
По утверждению авторов, SAE выделяют скрытые концепты, которые соответствуют очень конкретным и предсказательным лингвистическим «приметам» (tells) текста, созданного ИИ. Классификаторы, построенные на этих признаках, не только хорошо интерпретируемы, но и показывают более высокое качество на текстах вне распределения обучающих данных, чем нейросетевые и стилометрические альтернативы. Источник, краткая аннотация: цифр, названий детектора и наборов данных в ней нет.
Ключевые факты
- Детекторы ИИ-текстов применяют в рецензировании, образовании, приёмных комиссиях, журналистике и модерации, где вердикт влияет на конкретных людей.
- Лучшие детекторы, дообученные нейросети с непрозрачными решениями; прозрачные стилометрические и лингвистические классификаторы уступают им с большим отрывом.
- Конвейер: SAE на residual stream детектора, автоматические описания признаков, отбор по глобальному порогу достоверности, лёгкий классификатор на оставшихся признаках.
- Авторы сообщают, что найденные признаки соответствуют конкретным лингвистическим «приметам» ИИ-текста.
- По заявлению авторов, такие классификаторы лучше нейросетевых и стилометрических на текстах вне распределения обучения.
Почему это важно
Детекторы ИИ-текстов используются там, где ошибка бьёт по человеку: студента могут заподозрить в списывании, автора статьи, в генерации текста. Если самые точные детекторы объясняют свои решения не лучше чёрного ящика, оспорить вердикт трудно. Работа предлагает путь к проверяемым решениям без отказа от силы нейросетевого детектора.
Кому это важно
Исследователям интерпретируемости и разработчикам детекторов ИИ-текстов; редакциям, учебным заведениям и платформам модерации, которые опираются на такие инструменты и заинтересованы в объяснимых вердиктах.
Как это применить
В аннотации не упомянуты ни код, ни готовый инструмент, поэтому о прямом применении говорить рано. Идея для практиков: вместо прямого использования нейросетевого вердикта строить лёгкий классификатор на отобранных интерпретируемых признаках и показывать, какие именно «приметы» сработали.
Можно ли доверять
Источник, аннотация препринта на Hugging Face; все утверждения принадлежат самим авторам. В тексте нет численных результатов, названий детектора, наборов данных и тестов вне распределения, поэтому заявленное превосходство на таких текстах проверить по нему нельзя. Не сказано и то, сравнимо ли качество нового классификатора с исходным нейросетевым детектором на обычных данных.
Риски и подводные камни
Аннотация не раскрывает, какая модель создаёт описания признаков и как измеряется достоверность описаний, а от этого зависит надёжность всего отбора. Не названо и то, какие именно лингвистические «приметы» найдены. Без этих деталей неясно, насколько устойчив метод к текстам разных жанров и к обходу детекции.