Google представила StreamVibe: видеоагент сам решает, когда подсказать
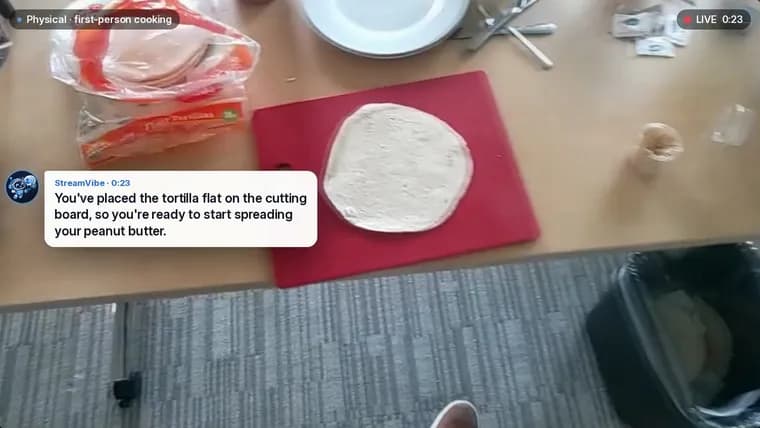
Исследователи из Google, Стэнфорда, Оксфорда и нескольких американских университетов работают над ассистентом, который смотрит, как вы готовите или собираете мебель, и вмешивается только при необходимости. Их разработка называется StreamVibe: это видеоагент, рассчитанный на понимание даже расплывчатых просьб вроде «Помоги мне, если у меня возникнут трудности». По словам авторов статьи, существующие видеоассистенты заточены под чёткие команды («Скажи, когда закипит вода») и потому редко улавливают невысказанные намерения. Им также трудно отслеживать, что уже сделано, из-за чего они повторяют советы или отвечают слишком поздно, а когда пользователь меняет просьбу на полпути, часто держатся первоначальной инструкции.
Чтобы измерить проблему, команда собрала тест примерно из 4100 примеров на основе более чем 183 часов записей повседневной жизни и работы с программами. Gemini 2.5 Flash предлагала, когда стоит помочь и что сказать, а четыре человека-оценщика должны были единогласно одобрить каждый пример. Тест охватывает три стадии: чёткие инструкции, расплывчатые цели и просьбы, меняющиеся со временем. В одном из примеров пользователь, разбирающий игрушечный экскаватор, сначала просит сообщать о ходе работы, а через три минуты переключается на запрос проверки качества.
Затем исследователи обучили модель StreamVibe-VL, по всей видимости, на основе Qwen3.5-9B от Alibaba. Каждую секунду она решает, промолчать или заговорить. Второй этап обучения использует обучение с подкреплением, чтобы сделать модель сдержаннее и не дать ей постоянно перебивать. Отдельная система памяти отслеживает, какие просьбы ещё не выполнены и какие шаги завершены, но говорить или молчать и что именно сказать решает только сама модель.
По словам исследователей, StreamVibe-VL улучшает время и качество ответов на 10,7 процента по сравнению с другими моделями, а система памяти, как задумано, даёт ещё 12,3 процента к проактивному взаимодействию и среди прочего сокращает лишние вмешательства. StreamVibe-VL в целом с большим отрывом опережает свою базовую модель и другие открытые модели, хотя собственная закрытая модель Google Gemini 3.8 Flash в ряде тестов показывает результат выше. Согласно статье, узкая специализация не вредит общему пониманию видео.
Главный вывод тестов, трудность задачи. Когда модели нужно лишь в отдельные моменты решить, уместна ли подсказка, они часто принимают верное решение. Но когда система обрабатывает всё видео целиком и опирается на собственные прежние ответы, результаты всех проверенных систем резко падают из-за накопления ошибок: ключевая содержательная метрика ответов снижается вплоть до 61,5 процента из-за собственной истории системы. В видео длиннее пяти минут модели редко выбирают правильный момент, а изменённую инструкцию им особенно трудно удерживать на длинном отрезке.
В примере из статьи и на странице проекта, урок по превращению фото в чёрно-белое в GIMP, модель сравнения JoyAI заявляет, что готовое изображение уже сохранено, хотя пользователь его ещё не открывал, а StreamVibe-VL вовремя подсказывает следующий шаг: «Colors», затем «Desaturate». В инструкции по рулету из тоста с вареньем другие модели просто описывают происходящее на экране (хлеб сплющивают), а StreamVibe-VL советует сначала обрезать корку. Исследователи признают, что реальные ситуации, вероятно, сложнее их тестовой постановки; в дальнейшей работе они намерены изучить, как предпочтения пользователя и окружение влияют друг на друга со временем.
Ключевые факты
- Команда во главе с Google (с участием Стэнфорда, Оксфорда и ряда американских университетов) представила видеоагента StreamVibe, который сам решает, когда вмешаться, и понимает расплывчатые просьбы.
- Тест состоит примерно из 4100 примеров на основе более чем 183 часов записей; каждый пример единогласно одобрили четыре оценщика-человека, три стадии, от чётких инструкций до меняющихся просьб.
- По данным исследователей, StreamVibe-VL (по всей видимости, на базе Qwen3.5-9B) улучшает время и качество ответов на 10,7 процента относительно других моделей; Gemini 3.8 Flash в ряде тестов всё же выше.
- При обработке всего видео и опоре на свои прежние ответы результаты всех протестированных систем резко падают: ключевая метрика снижается вплоть до 61,5 процента.
- В видео длиннее пяти минут модели редко выбирают верный момент для подсказки и плохо удерживают изменённую инструкцию.
Почему это важно
Нынешние видеоассистенты реагируют на чёткие команды, а полезный помощник должен сам понять, что человеку нужна помощь, и не мешать, когда она не нужна. StreamVibe, попытка научить модель решать это каждую секунду. Но тесты показывают прежде всего, насколько задача остаётся трудной: при непрерывной работе по целому видео ошибки накапливаются, и результаты всех проверенных моделей резко падают.
Кому это важно
Исследователям видеомоделей и ассистентов, которым нужен тест на выбор момента для подсказки и на работу с меняющимися просьбами. Разработчикам помощников для обучения, кулинарии, сборки и работы с программами, где ассистент наблюдает за пользователем в реальном времени. Тем, кто следит за линией Google по видеоанализу с участием агентов.
Как это применить
Прямого применения пока нет: в материале не сказано, опубликованы ли модель, тест или код, а планы Google по продуктам не названы. Практическая ценность сейчас, идеи: тест из трёх стадий (чёткие инструкции, расплывчатые цели, меняющиеся просьбы), второй этап обучения с подкреплением ради сдержанности и отдельная память о невыполненных просьбах и завершённых шагах при том, что решение о реплике остаётся за моделью.
Можно ли доверять
Материал, пересказ исследовательской статьи в The Decoder. Приросты 10,7 и 12,3 процента названы словами исследователей; из текста не ясно, это проценты или процентные пункты и по какой метрике и относительно какой базы. Баллы моделей не приведены, а то, что StreamVibe-VL построена на Qwen3.5-9B, в источнике дано с оговоркой «по всей видимости». Примеры с GIMP и тостом описаны по статье и странице проекта. Тестовые примеры частично предложила Gemini 2.5 Flash, хотя каждый одобрили четыре человека.
Риски и подводные камни
Падение результатов при непрерывной работе (до 61,5 процента по ключевой метрике) означает, что в реальном применении ассистент может терять нить, повторять советы или опаздывать. После пяти минут видео выбор момента ухудшается, а смену инструкции модели удерживают плохо. Сами авторы признают, что реальные ситуации, вероятно, сложнее тестовых. Кроме того, более сильной в ряде тестов оказалась закрытая Gemini 3.8 Flash, так что у открытой модели есть пределы.