FrameForge: видеомодели приспособили для генерации и правки изображений
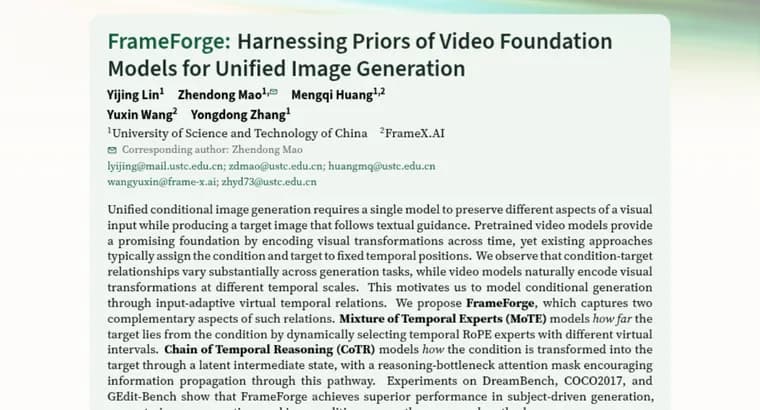
Статья на Hugging Face Papers описывает метод FrameForge для унифицированной условной генерации изображений. Задача в том, чтобы одна модель сохраняла разные аспекты входного изображения (условия) и при этом создавала целевое изображение, которое следует текстовой подсказке.
Исходная идея: предобученные видеомодели хорошо подходят в качестве основы, потому что кодируют визуальные преобразования во времени. Но существующие подходы, как отмечается в аннотации, обычно помещают условие и целевое изображение в фиксированные временные позиции видеомодели. Исследователи наблюдают, что связь между условием и результатом сильно различается от задачи к задаче, а видеомодели естественным образом кодируют преобразования в разных временных масштабах. Отсюда идея описывать условную генерацию через «виртуальные временные отношения», которые подстраиваются под входные данные.
FrameForge захватывает два взаимодополняющих аспекта таких отношений. Первый, Mixture of Temporal Experts (MoTE, «смесь временных экспертов»): модуль моделирует, насколько далеко цель находится от условия, динамически выбирая временные RoPE-эксперты с разными виртуальными интервалами. Второй, Chain of Temporal Reasoning (CoTR, «цепочка временных рассуждений»): он моделирует, как условие превращается в цель через скрытое промежуточное состояние; специальная маска внимания с «бутылочным горлышком рассуждения» побуждает информацию проходить именно по этому пути.
Эксперименты проведены на DreamBench, COCO2017 и GEdit-Bench. По заявлению в аннотации, FrameForge показывает лучшие результаты среди сравниваемых методов в генерации по образцу объекта (subject-driven), генерации по контурам Canny и редактировании изображений. Числовые результаты, названия сравниваемых методов и базовая видеомодель в аннотации не приводятся.
Ключевые факты
- FrameForge адаптирует предобученные видеомодели к единой условной генерации изображений: одна модель сохраняет аспекты входного изображения и следует тексту.
- Ключевое наблюдение: существующие подходы ставят условие и цель в фиксированные временные позиции, хотя связь между ними сильно зависит от задачи.
- Два компонента: MoTE выбирает временные RoPE-эксперты с разными виртуальными интервалами, CoTR моделирует переход через скрытое промежуточное состояние с помощью специальной маски внимания.
- Тесты на DreamBench, COCO2017 и GEdit-Bench: лучший результат среди сравниваемых методов в генерации по объекту, по контурам Canny и в редактировании.
- Числовых результатов, названий конкурентов и базовой видеомодели в аннотации нет.
Почему это важно
Работа предлагает способ использовать временные знания видеомоделей для задач с одним изображением: условие и цель трактуются как кадры с «виртуальным» расстоянием между ними. Вместо фиксированных позиций это расстояние подбирается под конкретную задачу. Это пример того, как видеомодели пытаются превратить в универсальную основу для генерации и редактирования картинок.
Кому это важно
Исследователям генеративных моделей изображений и видео, а также тем, кто занимается управляемой генерацией: по образцу объекта, по контурам и редактированием. Для практиков пока это скорее идея для наблюдения, чем готовый инструмент.
Как это применить
Из аннотации не следует, что метод можно взять и запустить: сведений о коде, весах или релизе в ней нет. Применимость сейчас, на уровне идеи: подбирать временные позиции условия и цели под задачу и использовать смесь временных RoPE-экспертов.
Можно ли доверять
Источник, аннотация препринта на Hugging Face Papers. Превосходство заявлено только «среди сравниваемых методов», числовых результатов и названий конкурентов в тексте нет, поэтому проверить масштаб улучшения по этому материалу нельзя. Имена авторов и организаций в тексте не указаны. Независимого подтверждения нет.
Риски и подводные камни
Преимущество показано лишь на трёх наборах и трёх типах задач, и неизвестно, с кем именно сравнивали. Маска внимания лишь побуждает информацию идти через скрытое промежуточное состояние, гарантий этого нет. Данные об обучении, вычислительных затратах и размере модели в аннотации отсутствуют, так что стоимость применения оценить нельзя.