Embodied First Exam: лучший кодинг-агент управляет роботами лишь в 34% задач
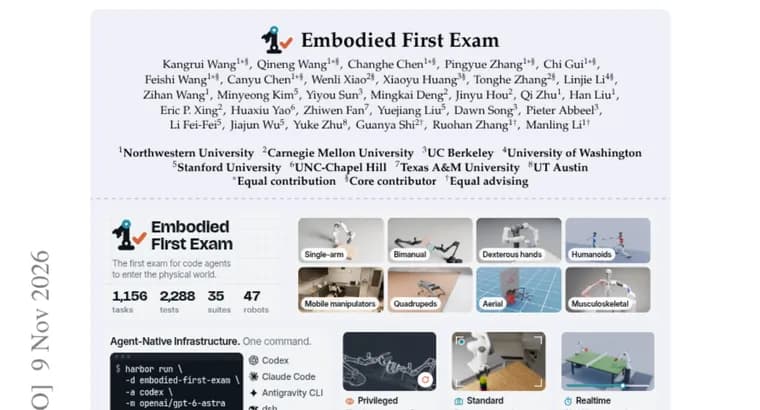
Авторы работы вводят Embodied First Exam, единую систему оценки, в которой кодинг-агенты управляют роботами. Исходная посылка: ранние успехи агентной робототехники указывают на возможный сдвиг парадигмы, когда роботами управляют кодинг-агенты. При этом существующие тесты для роботов построены вокруг обучения визуомоторных политик, и остаётся открытым вопрос, могут ли кодинг-агенты надёжно управлять разными роботами в условиях ограничений физического мира.
В новой системе агент сам выбирает подход к управлению: управлять напрямую, писать код для управления или обучать политику управления. Набор включает 1 156 задач в 35 наборах (suites) на 47 роботах. Девять наборов новые и выходят за рамки «взять и положить»: пространственные головоломки, ловкая манипуляция, взаимодействие нескольких роботов, динамическое управление всем телом и sim-to-sim-инженерия (перенос между симуляторами). Авторы надеются, что это станет «первым экзаменом» для кодинг-агентов перед выходом в физический мир.
Каждую задачу можно запускать максимум в трёх режимах оценки. Стандартный режим имитирует реальный мир: агент получает только показания датчиков и по умолчанию не может сбросить среду. Его вариант Realtime не останавливает среду, пока агент рассуждает. Привилегированный режим открывает агенту полное состояние симулятора и неограниченные сбросы, так что он может искать эталонное («оракульное») решение для целей обучения; успешность в этом режиме служит приблизительной верхней границей.
Главный результат: на 456 основных задачах сильнейший из восьми протестированных агентов, GPT-6 Astra в Codex, достигает успешности 34% в стандартном режиме. Авторы считают, что это оставляет много места для улучшений. Чтобы понять, где агенты ошибаются, они размечают стадию, на которой проваливается неудачная попытка, и сравнивают сбои между агентами, режимами и категориями стадий.
Ключевые факты
- Embodied First Exam, бенчмарк для кодинг-агентов, управляющих роботами: 1 156 задач в 35 наборах на 47 роботах.
- Девять наборов новые и выходят за рамки «взять и положить»: пространственные головоломки, ловкая манипуляция, взаимодействие нескольких роботов, управление всем телом, sim-to-sim-инженерия.
- Агент сам выбирает способ: управлять напрямую, писать управляющий код или обучать политику.
- Три режима: стандартный (только датчики, без сброса по умолчанию), его вариант Realtime и привилегированный (полное состояние симулятора, неограниченные сбросы) как приблизительная верхняя граница.
- На 456 основных задачах лучший из восьми агентов, GPT-6 Astra в Codex, достиг 34% в стандартном режиме.
Почему это важно
Кодинг-агенты всё чаще предлагают как способ управлять роботами, но существующие тесты заточены под обучение визуомоторных политик и не отвечают на вопрос, надёжны ли такие агенты на разных роботах в физических ограничениях. Embodied First Exam пытается закрыть этот пробел единой системой оценки, где агент сам выбирает подход. Результат в 34% у сильнейшего из восьми агентов показывает, что до надёжного управления роботами кодинг-агентам ещё далеко.
Кому это важно
Исследователям робототехники и агентных систем, которым нужен общий тест для сравнения кодинг-агентов на разных роботах. Разработчикам агентов, как ориентир, где именно они ломаются: авторы размечают стадию сбоя. Тем, кто оценивает идею «агент пишет код для робота», как трезвая отправная точка.
Как это применить
Бенчмарк задуман как «первый экзамен» для кодинг-агента перед выходом в физический мир: прогнать агента по задачам в стандартном режиме, сравнить с привилегированным режимом как с приблизительным потолком и посмотреть, на каких стадиях происходят сбои. Для разработки полезны три режима: Realtime проверяет работу, когда среда не ждёт рассуждений агента, а привилегированный позволяет искать эталонное решение для обучения.
Можно ли доверять
Это пересказ аннотации работы со страницы Hugging Face Papers; результаты заявлены самими авторами. Названа только лучшая из восьми систем с её результатом; имена остальных семи агентов и их показатели не приведены. Успешность в привилегированном режиме и в Realtime тоже не указана, как и разбивка причин сбоев. В тексте нет данных о запусках на реальных роботах; упоминаются состояние симулятора и sim-to-sim-инженерия. Принцип выбора 456 основных задач из 1 156 не раскрыт.
Риски и подводные камни
Результат 34% относится к 456 основным задачам и стандартному режиму, а не ко всем 1 156 задачам и не к привилегированному режиму; переносить число на весь набор нельзя. Привилегированный режим даёт лишь приблизительную верхнюю границу. Рейтинг зависит от того, как выбраны основные задачи, а это в аннотации не объяснено. Сравнение агентов отражает версии на момент оценки и вряд ли будет вечным.