Deletion Tuning: обнуление менее 0,05% весов нейросети заменило полное дообучение
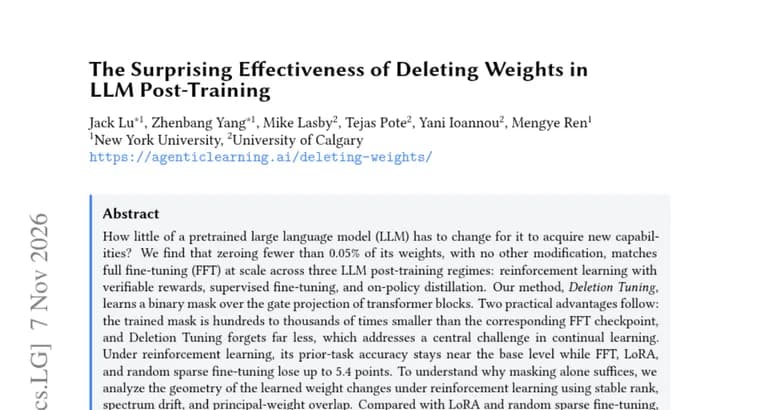
В статье, опубликованной в разделе Hugging Face Papers, ставится вопрос: насколько мало нужно изменить в предобученной большой языковой модели, чтобы она приобрела новые способности? Авторы утверждают, что достаточно обнулить менее 0,05% её весов, без каких-либо других изменений, и результат будет на уровне полного дообучения (FFT, full fine-tuning) в больших масштабах.
Это сравнение сделано для трёх режимов постобучения: обучения с подкреплением с проверяемыми вознаграждениями, обучения с учителем (supervised fine-tuning) и on-policy distillation (дистилляции).
Метод называется Deletion Tuning. Он обучает бинарную маску поверх gate-проекции (gate projection) блоков трансформера: маска определяет, какие веса обнулить.
Авторы выделяют два практических преимущества. Во-первых, обученная маска в сотни или тысячи раз меньше соответствующего чекпойнта полного дообучения. Во-вторых, Deletion Tuning заметно меньше забывает ранее выученное, и это, по словам авторов, затрагивает центральную проблему непрерывного обучения. При обучении с подкреплением точность на прежних задачах у Deletion Tuning остаётся около базового уровня, тогда как при FFT, LoRA и случайном разреженном дообучении она падает на величину до 5,4 пункта.
Чтобы понять, почему хватает одной маски, авторы разобрали геометрию изменений весов при обучении с подкреплением по трём показателям: стабильный ранг (stable rank), дрейф спектра и пересечение главных весов. По всем трём Deletion Tuning оказался ближе всего к полному дообучению по сравнению с LoRA и случайным разреженным дообучением.
В аннотации не названы авторы и организации, модели, их размеры, бенчмарки и наборы данных; точных цифр качества для сравнения с FFT тоже нет, сказано лишь, что результат «совпадает».
Ключевые факты
- Deletion Tuning обучает бинарную маску поверх gate-проекции блоков трансформера; по заявлению авторов, обнуления менее 0,05% весов хватает, чтобы сравняться с полным дообучением.
- Совпадение с полным дообучением заявлено в трёх режимах: обучение с подкреплением с проверяемыми вознаграждениями, обучение с учителем и on-policy distillation.
- Обученная маска в сотни или тысячи раз меньше чекпойнта полного дообучения.
- При обучении с подкреплением точность на прежних задачах у метода держится около базового уровня, а у FFT, LoRA и случайного разреженного дообучения падает на величину до 5,4 пункта.
- По стабильному рангу, дрейфу спектра и пересечению главных весов метод ближе всего к полному дообучению среди LoRA и случайного разреженного варианта.
Почему это важно
Обычно считается, что для освоения моделью новых навыков нужно менять много весов. Авторы утверждают обратное: достаточно обнулить совсем небольшую долю, менее 0,05%, и результат сравнится с полным дообучением. Если это подтвердится независимо, то набор изменений для каждой новой задачи превращается в крошечную маску, которая в сотни или тысячи раз меньше обычного чекпойнта. Кроме того, заявлено меньшее забывание прежних навыков при обучении с подкреплением, а это одна из центральных трудностей непрерывного обучения.
Кому это важно
Исследователям постобучения и непрерывного обучения, командам, которые дообучают одну базовую модель под много задач и хранят множество чекпойнтов, а также тем, кто сравнивает методы эффективного дообучения вроде LoRA. Практикам пока рано что-либо внедрять: это результат одной статьи.
Как это применить
Из аннотации видно лишь устройство метода: бинарная маска обучается над gate-проекцией блоков трансформера, и обучение сводится к выбору обнуляемых весов. Выпуск кода или чекпойнтов в аннотации не упомянут. Практический вывод на сегодня: следить за статьёй и за независимыми воспроизведениями, а при выборе способа дообучения сравнивать метод с LoRA и полным дообучением на собственной задаче.
Можно ли доверять
Все утверждения принадлежат авторам статьи и приведены по её аннотации. В аннотации не названы авторы и организации, модели и их размеры, бенчмарки и наборы данных, нет точных цифр качества: сказано только, что метод «совпадает» с полным дообучением. Число 5,4 пункта, это максимальная потеря точности на прежних задачах при обучении с подкреплением, и не указано, у какого из методов (FFT, LoRA или случайного разреженного дообучения) она наибольшая. Оценить масштаб и корректность сравнения по аннотации нельзя; нужна полная версия статьи и независимая проверка.
Риски и подводные камни
Заявление «совпадает с полным дообучением» не подкреплено в аннотации числами, поэтому разброс результата по задачам и моделям неизвестен. Названа только gate-проекция блоков трансформера; о других частях модели аннотация ничего не говорит. Данных об экономии вычислений или времени обучения нет: преимущества, которые указаны, касаются размера маски и забывания. Пока нет независимых воспроизведений, результат стоит считать предварительным.
«Насколько мало нужно изменить в предобученной большой языковой модели, чтобы она приобрела новые способности?»
— Из аннотации статьи