Дистилляция модели мира подняла точность VLA-робота без потери скорости
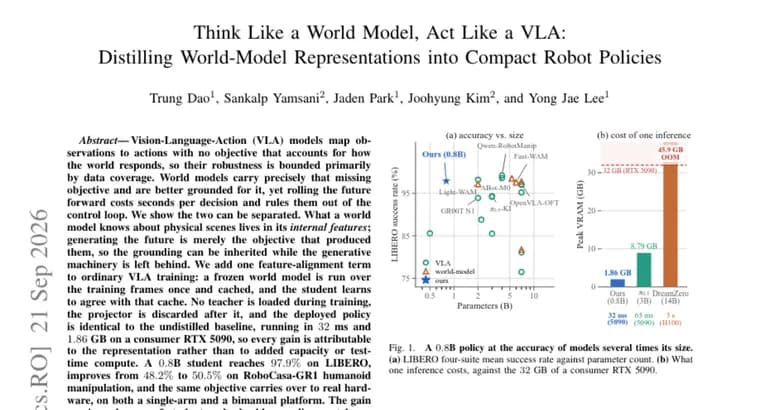
VLA-модели («видение-язык-действие») напрямую сопоставляют то, что видит робот, с тем, что ему делать, но при обучении у них нет цели, которая учитывала бы, как мир отвечает на действия, поэтому их устойчивость к новым ситуациям упирается прежде всего в объём и разнообразие обучающих данных. Модели мира (world models) как раз содержат эту недостающую цель и лучше привязаны к физике сцены, но прогон модели мира вперёд по времени занимает секунды на каждое решение, и это исключает их из контура управления роботом в реальном времени.
Авторы работы показывают, что эти два свойства можно разделить. То, что модель мира знает о физической сцене, хранится в её внутренних признаках (representations); генерация будущего кадра, лишь задача, которая эти признаки породила. Значит, привязку к реальности можно унаследовать, не утаскивая за собой генеративный механизм. Для этого к обычному обучению VLA-политики добавляется один дополнительный член потерь на выравнивание признаков: замороженная модель мира один раз прогоняется по обучающим кадрам, её представления кэшируются, а студенческая политика учится согласовываться с этим кэшем. Модель-учитель во время обучения студента не загружается вовсе, после обучения модуль выравнивания (проектор) выбрасывается, а развёрнутая политика архитектурно идентична недистиллированному базовому варианту, работает за 32 мс и занимает 1,86 ГБ памяти на потребительской видеокарте RTX 5090. Из этого авторы делают вывод, что весь выигрыш в качестве идёт от унаследованного представления, а не от добавленной ёмкости модели или дополнительных вычислений на этапе вывода.
Студенческая политика на 0,8 млрд параметров достигает 97,9% на бенчмарке LIBERO и поднимает результат с 48,2% до 50,5% на RoboCasa-GR1, задаче манипуляции для человекоподобного робота. Тот же приём переносится и на реальное оборудование: авторы заявляют выигрыш на однорукой и на двурукой (бимануальной) роботизированных платформах, не приводя по ним точных чисел. Эффект, по их словам, сохраняется при смене масштаба студента, его базовой архитектуры, слоя выравнивания и самой модели-учителя, то есть речь идёт о широкой закономерности в представлениях, а не о случайной удачной подгонке двух конкретных сетей друг под друга.
Имена авторов и их организация в тексте не приведены, источник называет только первого автора заявки (Trung Dao), но состав всей команды это не описывает. Не названа и конкретная модель мира, использованная в роли учителя, и то, как она обучалась.
Ключевые факты
- Метод: один дополнительный член потерь при обучении VLA-политики, выравнивание её признаков с закэшированными представлениями замороженной модели мира; на этапе вывода модель-учитель не нужна вовсе.
- Развёрнутая политика архитектурно идентична недистиллированной базовой модели: 32 мс на решение и 1,86 ГБ памяти на потребительской RTX 5090, выигрыш не за счёт добавленной ёмкости или вычислений на выводе.
- Студент на 0,8 млрд параметров даёт 97,9% на бенчмарке LIBERO; на RoboCasa-GR1 (манипуляция для человекоподобного робота) результат вырос с 48,2% до 50,5%.
- Выигрыш подтверждён и на реальном оборудовании, однорукой и двурукой (бимануальной) платформах, а также устойчив к смене масштаба студента, архитектуры, слоя выравнивания и модели-учителя.
- Имена авторов, их организация и конкретная модель мира, использованная как учитель, в тексте не названы.
Почему это важно
Обычно у разработчиков роботов был выбор: либо быстрая VLA-политика без явного понимания физики сцены, либо медленная модель мира, которая эту физику понимает, но не годится для управления в реальном времени. Эта работа показывает, что понимание физики можно перенести из модели мира в VLA-политику ещё на этапе обучения, одним дополнительным членом потерь, и оставить развёрнутую систему такой же быстрой и лёгкой, какой она была бы без этого. То есть цена «понимания мира» переносится с этапа вывода на этап обучения, где секунды на кадр не критичны.
Кому это важно
В первую очередь, командам, которые обучают VLA-политики для роботов-манипуляторов и хотят повысить их устойчивость к новым ситуациям без изменения архитектуры и скорости готовой модели. Также интересно исследователям, которые работают с моделями мира и ищут им практическое применение за пределами дорогой генерации будущих кадров.
Как это применить
Приём встраивается в обычный пайплайн обучения VLA: взять любую уже существующую замороженную модель мира, один раз прогнать её по обучающим кадрам и закэшировать признаки, добавить в функцию потерь студенческой политики член, который заставляет её признаки совпадать с этим кэшем, а после обучения выбросить и модель-учителя, и модуль выравнивания. Авторы указывают, что метод устойчив к смене масштаба студента, базовой архитектуры и конкретной модели-учителя, то есть не требует точного подбора пары «учитель-ученик». Страница проекта: https://thaw-vla.trung-dt.com/.
Можно ли доверять
Источник, препринт на HuggingFace Papers, отдельно от которого недоступны ни имена всех авторов, ни их организация, ни сведения о рецензировании; в тексте фигурирует только имя первого автора заявки. Числа по LIBERO и RoboCasa-GR1 приведены заявителями как собственные измерения, без сравнения с другими методами дистилляции или альтернативными VLA-базами, кроме недистиллированного варианта той же модели. Результаты на реальном железе заявлены текстом без конкретных цифр.
Риски и подводные камни
Ключевые заявления, о переносе на реальное оборудование и об устойчивости эффекта к смене учителя и архитектуры, это самооценка авторов, не подтверждённая независимым воспроизведением или рецензированием. Нет сопоставления с другими существующими методами дистилляции знаний в робо-политики, поэтому неясно, насколько выигрыш специфичен именно для этого приёма. Также не раскрыто, какая именно модель мира использовалась как учитель и насколько дорога подготовка кэша признаков для больших датасетов.