GAE: исследователи представили геометрический латент для 3D-генерации сцен
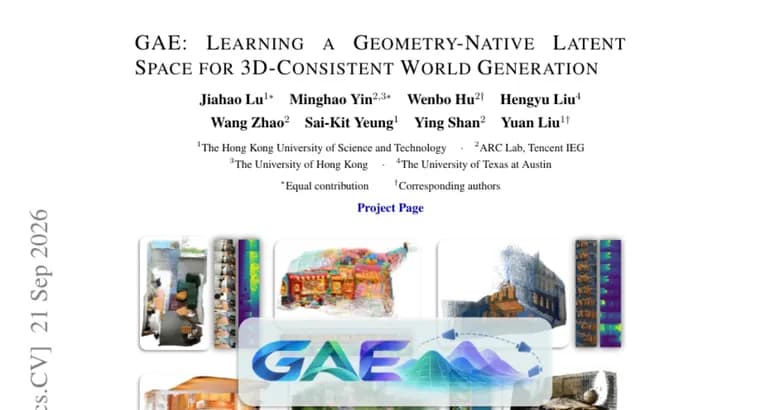
Генеративные модели умеют рисовать фотореалистичные кадры, но не обязаны при этом сохранять единую согласованную 3D-сцену: соседние кадры могут выглядеть правдоподобно каждый по отдельности и при этом не складываться в физически связную геометрию. Авторы работы утверждают, что дело не только в самой модели генерации, а в представлении данных: генераторы обычно работают с «латентами, ориентированными на внешний вид», они описывают, как кадр выглядит, тогда как модели восприятия (perception) восстанавливают геометрию сцены в другом, более семантически насыщенном пространстве, которое явно кодирует структуру между разными ракурсами. Поскольку генерация и восприятие используют разные представления, согласованность 3D-сцены страдает.
Чтобы решить эту проблему, авторы не добавляют геометрию как ещё один отдельный выход модели, а перерабатывают признаки уже существующей геометрической базовой модели (geometry foundation model) в компактное латентное пространство, пригодное для генерации. Результат назван geometry-native autoencoder, GAE. Его латентное представление устроено так, что из него можно одновременно декодировать внешний вид кадра, карту глубины, параметры камеры и точечную карту сцены (3D-облако точек). Поскольку все эти данные закодированы в едином латенте, поверх него можно обучить стандартную модель условной генерации (conditional flow) и решать разные задачи генерации без специальных архитектур под каждую из них.
Эффект проверили в контролируемом сравнении: архитектуру генератора и протокол обучения оставили без изменений, поменяв только латентное представление на GAE вместо базового варианта. Замена улучшила одновременно визуальное качество и независимо измеренную 3D-согласованность. Метрика FVD (Fréchet Video Distance, чем ниже, тем более реалистично и согласованно выглядит сгенерированное видео) снизилась на 12,7% на бенчмарке RealEstate10K и на 23,1% на бенчмарке DL3DV. Ошибка восстановления траектории камеры, насколько движение камеры, «прочитанное» из сгенерированного видео, совпадает с реальным, на RealEstate10K сократилась вдвое.
В тексте работы не названы конкретные модели или методы, с которыми сравнивали результат, только «базовый латент» до замены на GAE; не приведены абсолютные значения FVD и ошибки камеры, только относительное изменение; нет данных о размере модели, объёме обучающих вычислений или дате возможного релиза кода.
Ключевые факты
- GAE, компактное латентное пространство, объединяющее восприятие и генерацию сцены в одном представлении
- Один и тот же латент декодируется одновременно во внешний вид кадра, карту глубины, параметры камеры и точечную карту сцены
- При неизменных архитектуре генератора и протоколе обучения замена латента на GAE снижает FVD на 12,7% (RealEstate10K) и на 23,1% (DL3DV)
- Ошибка восстановления траектории камеры на RealEstate10K сокращается вдвое
- В статье не названы конкретные конкурирующие методы для сравнения и не приведены абсолютные значения метрик, только относительные изменения
Почему это важно
Проблема, которую решают авторы, не «модель делает недостаточно реалистичные кадры», а более фундаментальная: генеративные модели видео и сцен исторически работают с латентным представлением, заточенным под внешний вид кадра, а не под геометрию сцены. Из-за этого фотореалистичные кадры могут не складываться в согласованную 3D-сцену, камера как бы «плывёт», а объекты меняют форму между кадрами. Работа переносит решение этой проблемы на уровень представления данных: если сделать так, чтобы генерация и восприятие геометрии использовали общий латент, согласованность сцены перестаёт быть отдельной задачей, которую нужно доучивать поверх готового генератора.
Кому это важно
В первую очередь, исследовательским командам и инженерам, которые строят генераторы видео, 3D-сцен и «моделей мира» (world models): для них GAE предлагает готовый строительный блок, который можно подставить вместо стандартного латента и получить более согласованную геометрию без переделки остальной архитектуры генератора. Также это релевантно для команд, занимающихся восстановлением геометрии по видео и синтезом камеры/точечных карт, GAE decoder отдаёт эти данные напрямую из того же латента.
Как это применить
В тексте статьи нет указаний на релиз кода, весов модели или сроки, это исследовательская работа с оценкой метода на бенчмарках, а не готовый инструмент. Практически идея применима так: вместо обучения генератора на латенте автоэнкодера, ориентированного на внешний вид, его признаки заменяются на признаки, полученные из geometry-native autoencoder, латент при этом остаётся совместимым со стандартной архитектурой условной генерации (conditional flow), то есть переход не требует полной переработки генератора.
Можно ли доверять
Работа опубликована как препринт на arXiv и, судя по доступному тексту, не прошла независимое рецензирование. Сильная сторона методологии, контролируемое сравнение: авторы зафиксировали архитектуру генератора и протокол обучения и меняли только латентное представление, а улучшение измерили сразу двумя независимыми метриками (визуальное качество через FVD и геометрическая точность через ошибку траектории камеры) на двух разных бенчмарках. Слабое место, в тексте нет абсолютных значений метрик, только проценты изменения, и не названо, с каким конкретно базовым методом или латентом сравнивали GAE.
Риски и подводные камни
Результаты получены только на двух бенчмарках (RealEstate10K и DL3DV) без абсолютных цифр и без сравнения с конкретными существующими методами, оценить место GAE среди других подходов к 3D-генерации по этому тексту нельзя. Нет данных о размере модели, вычислительных затратах на обучение и о том, планируется ли открытая публикация кода или весов, поэтому воспроизвести или проверить результат независимо пока не на чем.