Co-Design Bench: лучшая из десяти моделей полностью решила лишь 26,4% задач
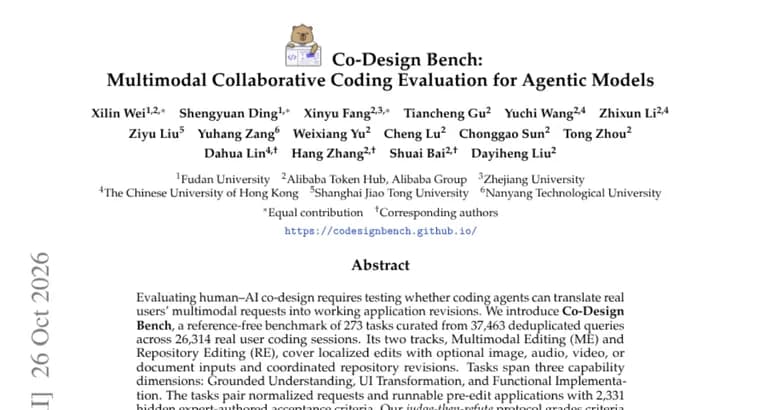
Авторы работы представили Co-Design Bench, бенчмарк (набор задач для проверки) для оценки совместного проектирования человека и ИИ. Он отвечает на вопрос: способны ли ИИ-агенты, пишущие код, превратить реальные мультимодальные запросы пользователей в работающие обновлённые версии приложений.
Бенчмарк не использует эталонных решений (reference-free). В нём 273 задачи, отобранные из 37 463 дедуплицированных запросов, которые взяты из 26 314 реальных сессий пользователей с кодовыми помощниками. Каждая задача сочетает нормализованный запрос и запускаемое приложение до правки, а проверяется скрытыми критериями приёмки: всего их 2 331, и написаны они экспертами.
У бенчмарка два трека. Multimodal Editing (ME), локальные правки, к запросу в которых могут прилагаться изображения, аудио, видео или документы. Repository Editing (RE), скоординированные изменения в репозитории. Задачи охватывают три группы способностей: Grounded Understanding (понимание запроса с опорой на контекст), UI Transformation (преобразование интерфейса) и Functional Implementation (реализация функциональности).
Оценка идёт по схеме judge-then-refute («оценить, затем опровергнуть»). Критерии оцениваются по исходному коду и по тому, как приложение ведёт себя в браузере. Положительные вердикты оспаривает отдельная проверяющая языковая модель. Визуальные и интерактивные утверждения проверяются без эталонного кода и без целевых скриншотов.
Результат: при общей для всех агентной обвязке (harness) сильнейшая из десяти оцениваемых моделей (model endpoints) в среднем по задачам проходит 69,9% критериев, но полностью выполняет лишь 26,4% задач. Кроме того, все десять моделей хуже справляются с правками репозитория, затрагивающими три или четыре типа изменений, чем с теми, где типов один или два. Авторы предлагают бенчмарк как площадку для изучения разрыва между частичным выполнением требований и полным успехом задачи при агентном выполнении.
Ключевые факты
- Co-Design Bench: 273 задачи, отобранные из 37 463 дедуплицированных запросов в 26 314 реальных сессиях программирования с ИИ.
- Проверка идёт по 2 331 скрытому критерию приёмки, написанному экспертами; эталонных решений нет.
- Два трека: Multimodal Editing (локальные правки с изображениями, аудио, видео или документами) и Repository Editing (правки репозитория).
- Сильнейшая из десяти моделей в среднем проходит 69,9% критериев на задачу, но полностью выполняет только 26,4% задач.
- Все десять моделей хуже справляются с правками репозитория, затрагивающими три-четыре типа изменений, чем с правками на один-два типа.
Почему это важно
Бенчмарк построен на запросах из реальных пользовательских сессий, а не на синтетических заданиях, и проверяет полный цикл: понять мультимодальный запрос и внести правку в рабочее приложение. Главная цифра показывает разрыв между частичным и полным успехом: лучшая из десяти моделей проходит в среднем 69,9% критериев на задачу, однако целиком закрывает только 26,4% задач. Для пользователя важен именно полный результат, и метрика по отдельным критериям его скрывает.
Кому это важно
Исследователям и разработчикам ИИ-агентов для программирования, которым нужен тест на реальных правках приложений с картинками, аудио, видео и документами. Командам, выбирающим модели для автоматизации доработки интерфейсов и функциональности, полезно знать, что полное выполнение задачи остаётся редким даже у сильнейшей модели из проверенных.
Как это применить
Co-Design Bench предлагается как испытательный стенд для изучения разрыва между частичным выполнением требований и полным успехом задачи при агентном выполнении. Его трёхмерная разметка (понимание, преобразование интерфейса, реализация функциональности) и два трека позволяют смотреть, на каком типе правок модель срывается. Ссылка на опубликованные код и данные в тексте источника не указана.
Можно ли доверять
Это описание работы в аннотации, независимого подтверждения в источнике нет. Методика заявлена достаточно строгой: критерии пишут эксперты и скрывают от моделей, положительные вердикты оспаривает отдельный проверяющий. Но оценщиком служит языковая модель. Источник не называет ни сильнейшую модель, ни остальные девять, ни авторов, поэтому понять, о каких именно системах идёт речь, нельзя. Цифра 69,9% относится только к лучшей модели; результаты остальных девяти не приведены.
Риски и подводные камни
Показатели получены при одной общей агентной обвязке, и результаты могут зависеть от её выбора; какая именно обвязка использована, в источнике не сказано. Выборка из 273 задач невелика по сравнению с 26 314 исходными сессиями. Для разрыва между правками на один-два и на три-четыре типа изменений в источнике указано лишь направление, без чисел. Автоматическая оценка через языковую модель может ошибаться и в положительную, и в отрицательную сторону.