EditAgent: исследователи расширили возможности ИИ-агента для редактирования изображений
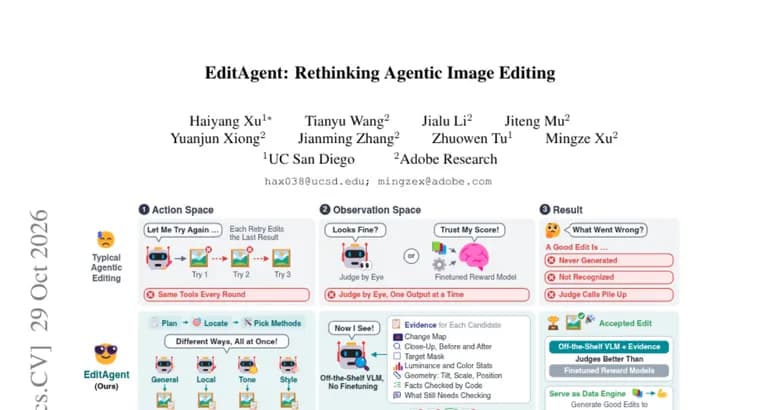
Агентные редакторы изображений разбивают сложный запрос на шаги, но когда шаг не удаётся, они, по словам авторов статьи, в основном повторяют попытку с тем же узким набором инструментов и с судьей, который оценивает результат на глаз, напрямую. Авторы утверждают, что такие агенты ограничены двумя пространствами: пространством действий (что агент может сделать) и пространством наблюдений (что может увидеть его судья).
На собственном бенчмарке, размеченном экспертами, универсальный редактор не даёт пригодного результата более чем в 40% случаев, а ни один судья не оказывается надёжным для всех типов правок. Чтобы расширить оба пространства, авторы представляют EditAgent. Система направляет каждый шаг и к универсальным редакторам, и к специализированным методам, а к каждому кандидату прикладывает запись о проверке (verification record).
С такими записями готовые VLM-судьи (визуально-языковые модели, использованные без дообучения) превосходят дообученные модели вознаграждения. Кандидаты генерируются параллельно и оцениваются одним вызовом судьи, который ранжирует весь список сразу (listwise). Эксперты предпочитают такой подход последовательному уточнению в 78,5% решённых сравнений, при этом он требует не более половины вызовов судьи. Кроме того, EditAgent улучшает два редактора с открытыми весами на трёх бенчмарках и служит «движком данных» для обучения более сильных редакторов.
Ключевые факты
- Авторы считают, что агентные редакторы изображений ограничены пространством действий (что умеет агент) и пространством наблюдений (что видит судья).
- На экспертно размеченном бенчмарке авторов универсальный редактор не даёт пригодного результата более чем в 40% случаев; надёжного для всех типов правок судьи нет.
- EditAgent направляет каждый шаг к универсальным и специализированным редакторам и прикладывает к каждому кандидату запись о проверке.
- С такими записями готовые VLM-судьи превосходят дообученные модели вознаграждения.
- Параллельная генерация кандидатов и один listwise-вызов судьи предпочтительны экспертам в 78,5% решённых сравнений по сравнению с последовательным уточнением, при не более чем половине вызовов судьи.
Почему это важно
Агентное редактирование изображений упирается в то, что при неудачном шаге система повторяет попытку с теми же инструментами и оценивает результат на глаз. Авторы предлагают смотреть на проблему через два пространства, действий и наблюдений, и расширять оба. По их данным, на их же бенчмарке универсальный редактор не справляется более чем в 40% случаев, так что узкий набор инструментов, реальное ограничение.
Кому это важно
Исследователям и разработчикам систем редактирования изображений на основе агентов и моделей-судей, а также тем, кто обучает редакторы: авторы заявляют, что EditAgent может служить движком данных для обучения более сильных редакторов.
Как это применить
Из аннотации следуют идеи: направлять шаги к специализированным методам, прикладывать к кандидатам записи о проверке для судьи, генерировать кандидатов параллельно и оценивать их одним listwise-вызовом вместо последовательного уточнения, это, по заявлению авторов, требует не более половины вызовов судьи. О выпуске кода, моделей или данных в тексте не сказано.
Можно ли доверять
Это аннотация статьи на странице Hugging Face; все цифры, заявления самих авторов и получены на их собственном экспертно размеченном бенчмарке. Показатель «более 40%» относится к универсальному редактору на этом бенчмарке, а не к общей частоте сбоев. Названия двух редакторов с открытыми весами, трёх бенчмарков и сравниваемых судей в тексте не приведены, величина улучшения тоже не указана, поэтому оценить масштаб эффекта по аннотации нельзя.
Риски и подводные камни
Результаты не проверены независимо: размер улучшения на трёх бенчмарках не назван, число экспертов и размер бенчмарка не указаны. Показатель 78,5% посчитан только по решённым сравнениям, без учёта ничьих и неопределённых случаев. Вывод о превосходстве готовых VLM-судей над дообученными моделями вознаграждения справедлив именно при наличии записей о проверке.