Блогер расширил приём с logprobs у LLM на модели компьютерного зрения
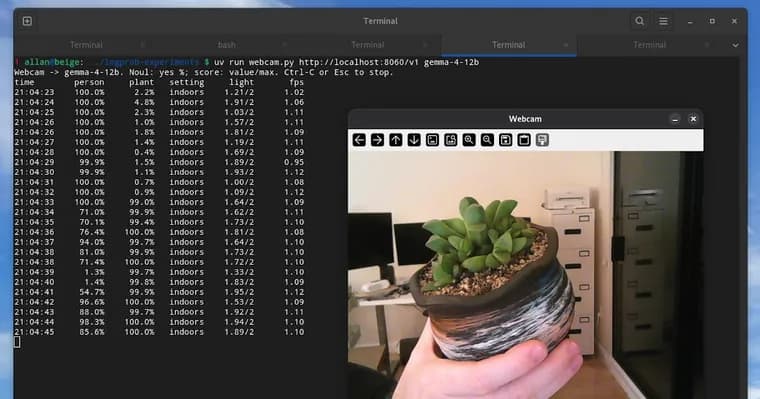
Автор блога рассказывает, что заинтересовался форматом запросов Jev и самостоятельно размещаемыми проектами вокруг него, OpenJev и SemIf. Через них он узнал приём считывания логарифмических вероятностей токенов (logprobs) у LLM: модели дают промпт с вариантами ответа, обозначенными буквами (например, [A] billing [B] shipping [C] returns), просят ответить только одной буквой и включают в запрос параметры max_completion_tokens=1 и top_logprobs=20. В ответ модель возвращает не только выбранную букву, но и логарифмические вероятности альтернативных токенов, из которых можно восстановить распределение вероятностей по всем вариантам. По словам автора, ограничение ответа одним токеном делает генерацию очень быстрой, хотя обработка самого входа всё равно занимает время; при поддержке со стороны сервера общий префикс для нескольких вопросов можно кешировать (KV-cache).
Документированный формат запросов Jev поддерживает только текстовое/JSON-состояние, поэтому автор добавил собственное поле attachments для передачи изображений в виде base64-кодированных JPEG, это его личное расширение, не часть официального формата Jev. С его помощью он протестировал приём на моделях зрения: собрал кадры с веб-камеры и по трём вопросам на кадр оценивал, виден ли человек, находится ли камера в помещении или на улице и насколько ярка сцена. На локальной модели Gemma 4 12B, запущенной на видеокарте RTX 3090, скорость обработки составила около 1 кадра в секунду. При обращении к OpenAI gpt-6-luna скорость упала примерно до 0.2 кадра в секунду, автор предполагает, что причина в отсутствии оптимизации: скрипт открывает отдельное соединение через API OpenAI на каждый вопрос для каждого кадра.
Автор опубликовал отдельный Python-скрипт, реализующий подход (OpenCV в нём используется только для доступа к веб-камере, а не для собственно компьютерного зрения), с поддержкой как локальных llama.cpp-совместимых серверов, так и OpenAI. Он признаёт, что специализированные модели компьютерного зрения наверняка намного эффективнее его подхода, но ценит гибкость: чтобы изменить условие проверки, достаточно описать его обычным текстом, не обучая отдельную модель.
Ключевые факты
- Идея восходит к проекту Jev и связанным с ним самостоятельно размещаемым инструментам OpenJev и SemIf: заставить LLM ответить одной буквой-вариантом и считать logprobs (логарифмические вероятности) альтернативных токенов, чтобы получить распределение вероятностей по вариантам ответа.
- Автор добавил в формат запроса Jev собственное поле attachments для передачи изображений в base64, это его личное расширение для экспериментов, а не часть официального формата.
- Тест на веб-камере (виден ли человек, помещение или улица, яркость сцены, по три вопроса на кадр): локальная модель Gemma 4 12B на видеокарте RTX 3090, около 1 кадра в секунду.
- Та же задача через OpenAI gpt-6-luna, около 0.2 кадра в секунду; автор связывает это с накладными расходами на отдельное соединение по API на каждый вопрос для каждого кадра.
- Автор опубликовал отдельный Python-скрипт с реализацией для llama.cpp-совместимых серверов и OpenAI и отмечает, что специализированные модели компьютерного зрения эффективнее, но привлекает гибкость: условие можно менять обычным текстом.
Почему это важно
Пост показывает недорогой способ получать от языковых и мультимодальных моделей не просто текстовый ответ, а откалиброванную вероятность по заданным вариантам, используя только один запрошенный токен и стандартный параметр logprobs API. Это расширяет известный текстовый трюк на модели с поддержкой изображений.
Кому это важно
Разработчикам, которые экспериментируют с локальными (llama.cpp) и облачными LLM/VLM и хотят быстро прототипировать классификаторы на естественном языке, например, простую фильтрацию или разметку кадров/текста, без обучения отдельной модели.
Как это применить
Автор выложил готовый Python-скрипт (запускается через uv run webcam.py, с опциональными аргументами URL и именем модели): вопросы задаются в JSON с типами choice, noul (да/нет) или score, а скрипт сам формирует промпт с буквенными вариантами, отправляет запрос с logprobs и нормализует полученные вероятности в итоговый ответ.
Можно ли доверять
Это личный блог-пост энтузиаста с открытым исходным кодом примера, что позволяет читателю самостоятельно проверить заявленные цифры; имя автора и дата публикации в тексте не указаны. Сама техника считывания logprobs описана как давно известная (со ссылкой на кулинарную книгу OpenAI по logprobs), а вклад автора, в переносе приёма на изображения и публикации рабочего примера.
Риски и подводные камни
Скорость обработки невысока, около 1 кадра в секунду локально и всего 0.2 кадра в секунду через OpenAI API, причём автор сам признаёт неоптимизированность своей реализации (отдельное соединение на каждый вопрос для каждого кадра). Подход также требует, чтобы бэкенд возвращал logprobs и достаточное число альтернативных токенов, иначе, по логике скрипта, вероятности для части вариантов окажутся ненадёжными. Сам автор указывает, что специализированные модели компьютерного зрения эффективнее этого метода.
«Специализированные модели компьютерного зрения наверняка гораздо эффективнее, но мне нравится в этом подходе гибкость: чтобы изменить условие, достаточно описать его обычным текстом.»
— автор блога