Claude Code и Codex обошли ручные планировщики в задачах планирования действий роботов
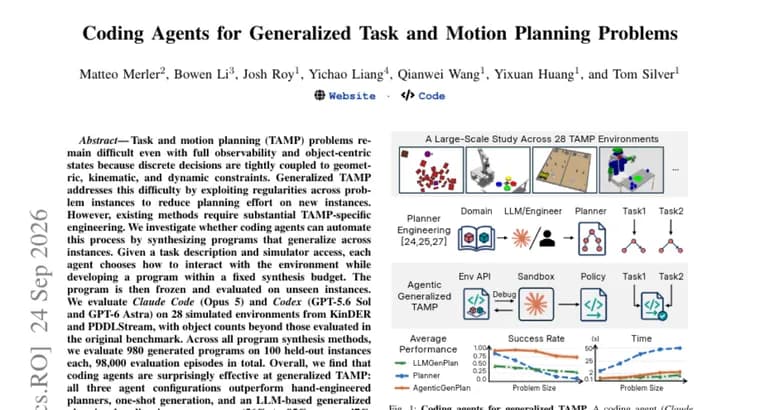
Исследователи проверили, способны ли агенты для написания кода автоматизировать так называемое обобщённое планирование задач и движений (generalized task and motion planning, TAMP), область, где нужно одновременно принимать дискретные решения (что делать) и учитывать геометрические, кинематические и динамические ограничения (как именно это физически выполнить). Обычно такие обобщающие методы планирования требуют большого объёма ручной инженерной работы под конкретную задачу. Авторы решили проверить, может ли агент сам написать программу, которая обобщается на новые, ранее не встречавшиеся варианты задачи.
В эксперименте агенту давали описание задачи и доступ к симулятору; агент сам решал, как взаимодействовать со средой, и в рамках ограниченного бюджета на синтез писал программу. После этого программа «замораживалась» и проверялась на новых, не встречавшихся ранее вариантах задачи. Протестировали три конфигурации агентов: Claude Code (Opus 5), а также Codex на моделях GPT-5.6 Sol и GPT-6 Astra. Тестирование проходило на 28 симулированных средах из наборов KinDER и PDDLStream, причём количество объектов в задачах превышало то, что использовалось в оригинальных бенчмарках. Всего было оценено 980 сгенерированных программ, каждую проверяли на 100 отложенных (не видимых во время синтеза) вариантах задачи, итого 98 000 эпизодов оценки.
Результат: все три конфигурации агентов превзошли по средней успешности как вручную спроектированные планировщики, так и генерацию программы с одной попытки, и специальный базовый метод обобщённого планирования на основе языковых моделей. На 16 средах, где ручной планировщик вообще был доступен для сравнения, успешность агентов составила от 56% до 95%, тогда как у планировщиков, 47%. При росте числа объектов в задаче программы агентов сохраняли более высокую успешность, чем планировщик, затрачивая при этом на порядок меньше вычислений на один эпизод в среднем. Логи работы агентов показывают, что они использовали взаимодействие со средой, чтобы калибровать физические модели, проверять граничные случаи и уточнять стратегии. Авторы публикуют весь код, включая полные тексты промптов, которые давались агентам, и делают вывод, что агенты для написания кода, сильная базовая точка отсчёта для обобщённого планирования задач и движений.
Ключевые факты
- Проверялось, могут ли кодовые ИИ-агенты сами писать программы для обобщённого планирования задач и движений роботов (TAMP) без ручной инженерии под конкретную задачу
- Протестированы три конфигурации: Claude Code (Opus 5), Codex на GPT-5.6 Sol и Codex на GPT-6 Astra, на 28 симулированных средах из KinDER и PDDLStream
- Всего оценено 980 сгенерированных программ по 100 отложенных вариантов задачи на каждую, 98 000 эпизодов оценки в сумме
- На 16 средах с доступным ручным планировщиком успешность агентов составила 56-95% против 47% у планировщика
- При росте числа объектов в задаче агенты сохраняли преимущество над планировщиком, тратя на порядок меньше вычислений на эпизод; авторы публикуют весь код и промпты
Почему это важно
Обобщённое планирование задач и движений, область, где раньше требовалась серьёзная ручная инженерная работа под каждую конкретную задачу: нужно было заранее закладывать структуру, которая учитывала бы геометрические, кинематические и динамические ограничения робота. Исследование показывает, что кодовые ИИ-агенты (Claude Code, Codex) способны сами, без этой ручной подготовки, синтезировать программы, которые не просто решают конкретный случай, а обобщаются на новые варианты задачи, и делают это успешнее вручную спроектированных планировщиков.
Кому это важно
Результат интересен исследователям и инженерам в области робототехники и автоматизированного планирования, а также разработчикам ИИ-агентов для написания кода, поскольку демонстрирует новую область их применения за пределами обычных задач разработки программного обеспечения.
Как это применить
Авторы обещают выложить в открытый доступ весь код эксперимента, включая полные тексты промптов, которые давались агентам, это позволит другим исследователям воспроизвести методику или адаптировать её под собственные среды планирования.
Можно ли доверять
Материал описывает конкретный количественный эксперимент: указаны число сред (28), число сгенерированных программ (980), число эпизодов оценки (98 000) и точные диапазоны успешности агентов и планировщиков. Однако в тексте не приводится ни авторов работы, ни даты публикации, ни точных подробностей о том, что представляет собой упомянутый базовый метод планирования на основе языковых моделей.
Риски и подводные камни
Сравнение с ручными планировщиками возможно только на 16 из 28 сред, там, где такой планировщик вообще существовал, так что для остальных сред прямого сопоставления нет. Также не раскрыто, что именно представляет собой упомянутый базовый метод обобщённого планирования на LLM, с которым тоже сравнивали агентов.