Бенчмарк FDE-Gym: лучший ИИ-агент решил лишь 14 из 95 задач
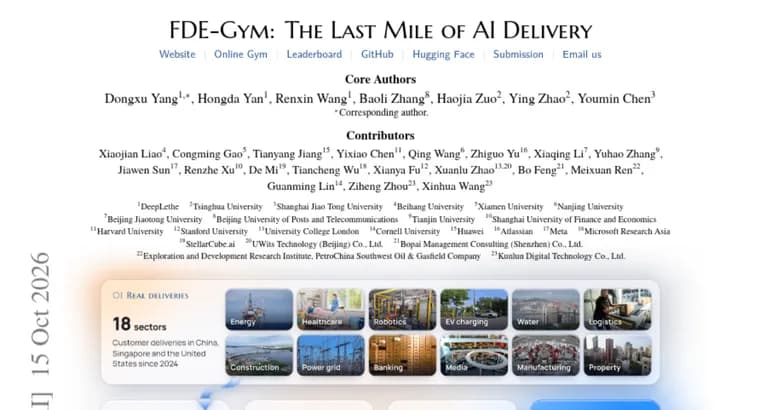
Существующие бенчмарки для ИИ-агентов обычно проверяют их на чётко поставленных задачах: описание ошибки, спецификация, тикет. Авторы статьи напоминают, что реальная работа инженеров по внедрению у заказчика (forward-deployed engineers, FDE) устроена иначе: нужно уточнять размытые требования, работать в живых системах и выявлять неозвученные ограничения.
Для проверки этого они представили FDE-Gym: 95 сквозных задач внедрения, взятых из 20 сценариев заказчиков в 18 отраслях. Каждую задачу отраслевые эксперты адаптировали из реальных проектов. Агенты действуют в имитируемых средах заказчика: там есть скриптовые заинтересованные лица (stakeholders), с которыми можно общаться, и изменяемые системы, похожие на боевые. Задача агента, довести до рабочего решения.
Оценка строится на том, насколько поставка улучшила собственную метрику успеха заказчика. Шкала нормирована от 0 (система не изменена) до 1 (эталонное решение). За взаимодействие с заинтересованными лицами начисляются штрафы: за сообщения, пробные запуски и время ожидания. Кроме того, авторы сделали онлайн-платформу, на которой люди могут тренировать навыки FDE по тем же критериям оценки.
Испытали 13 конфигураций моделей от семи провайдеров. В реалистичной постановке, где неозвученные ограничения нужно обнаружить самостоятельно, лучшая конфигурация получила средний балл 0,56 и решила только 14 из 95 задач; «решённой» считается задача с оценкой не ниже 0,8 и без инцидентов.
Главное узкое место, выявление неозвученных ограничений: когда у моделей нет явной подсказки, результат резко падает. Но дело не только в добыче информации. Есть 23 задачи, где лучшая конфигурация получила от заинтересованных лиц все ключевые факты, и даже там нормированный бизнес-эффект 0,8 и выше достигнут лишь в 10 случаях. Вывод авторов: между решением чётко поставленных задач и созданием действительно полезных ИИ-систем для реальных заказчиков остаётся существенный разрыв.
Ключевые факты
- FDE-Gym, бенчмарк из 95 сквозных задач внедрения, собранных из 20 сценариев заказчиков в 18 отраслях и адаптированных отраслевыми экспертами из реальных проектов.
- Оценка идёт по улучшению метрики успеха самого заказчика по шкале от 0 (система без изменений) до 1 (эталонное решение), со штрафами за сообщения, пробные запуски и время ожидания.
- Из 13 конфигураций моделей семи провайдеров лучшая в реалистичной постановке получила средний балл 0,56 и решила только 14 из 95 задач (оценка не ниже 0,8 и без инцидентов).
- Главное узкое место, обнаружение неозвученных ограничений: без явной подсказки результат резко падает.
- Даже на 23 задачах, где лучшая конфигурация получила все ключевые факты, бизнес-эффект 0,8 и выше достигнут только в 10.
Почему это важно
Большинство популярных бенчмарков для агентов проверяют умение выполнить чётко описанную задачу. FDE-Gym смещает акцент на то, что происходит при реальном внедрении: требования размыты, система уже работает у заказчика, а важные ограничения никто не сформулировал. Результат, лучшая конфигурация решает лишь 14 из 95 задач, показывает, что успехи на аккуратно поставленных задачах плохо переносятся на «последнюю милю» поставки ИИ-решений клиентам.
Кому это важно
Командам, которые внедряют ИИ-агентов у заказчиков или планируют это делать, и интеграторам: бенчмарк описывает именно их рабочую ситуацию. Также он полезен исследователям, которые строят оценки агентов: вместо прохождения тестов здесь измеряется улучшение бизнес-метрики клиента с учётом цены общения с заинтересованными лицами.
Как это применить
Практический вывод из результатов: при внедрении агента не стоит полагаться на то, что он сам выяснит скрытые ограничения заказчика. Это самое слабое место, поэтому явные чек-листы ограничений и участие человека в сборе требований выглядят разумной мерой. Кроме того, авторы предлагают онлайн-платформу, где людям можно тренировать навыки инженера по внедрению по тем же критериям, что и агентам. Данных о том, доступны ли код и данные бенчмарка публично, в источнике нет.
Можно ли доверять
Это описание статьи с её собственными результатами: цифры взяты из аннотации и не перепроверены независимо. Среда построена на имитации заказчиков и скриптовых заинтересованных лиц, так что перенос результатов на живые проекты остаётся вопросом. Аннотация не называет лучшую конфигурацию и семь провайдеров и не приводит оценок остальных конфигураций, поэтому сравнить конкретные продукты по ней нельзя.
Риски и подводные камни
Оценка 0,56 и порог «решено» в 0,8 без инцидентов, выбор авторов; другая метрика могла бы дать иную картину. Результат относится к реалистичной постановке с необходимостью самостоятельно искать ограничения; оценок для постановки с явными подсказками в аннотации нет. Кроме того, штрафы за сообщения, пробные запуски и ожидание влияют на итоговый балл, так что низкие значения отчасти отражают и цену взаимодействия, а не только способности модели.
«Эти результаты показывают существенный разрыв между решением чётко поставленных задач и созданием эффективных ИИ-систем для реальных заказчиков.»
— Из аннотации статьи FDE-Gym