Бенчмарк WorldCast проверил 12 моделей: лидер набрал 72,8, открытая, 20,1
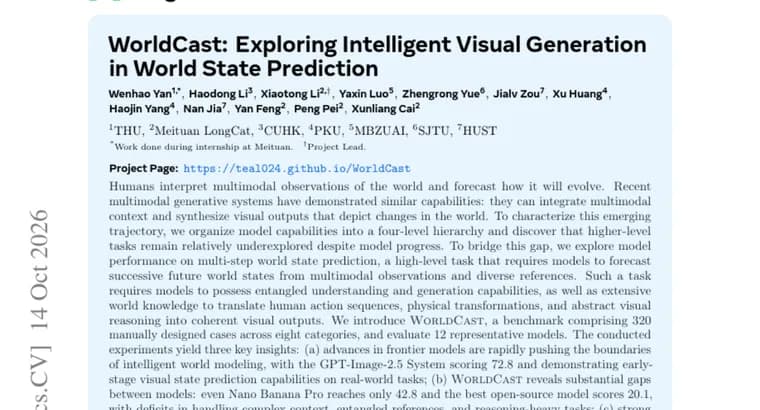
Авторы статьи исходят из того, что люди интерпретируют мультимодальные наблюдения о мире и предсказывают, как он будет меняться, а современные мультимодальные генеративные системы умеют нечто похожее: объединяют разнородный контекст и создают изображения, показывающие изменения в мире. Чтобы описать эту траекторию, авторы организуют возможности моделей в четырёхуровневую иерархию и делают вывод, что задачи верхних уровней остаются относительно малоизученными, несмотря на прогресс моделей.
Чтобы закрыть этот пробел, они исследуют многошаговое предсказание состояния мира, задачу высокого уровня, где модель должна предсказать последовательные будущие состояния мира по мультимодальным наблюдениям и разнообразным референсам (опорным материалам). По мнению авторов, для этого нужны переплетённые способности к пониманию и генерации, а также обширные знания о мире, чтобы превращать последовательности человеческих действий, физические преобразования и абстрактные визуальные рассуждения в связные визуальные результаты.
Для оценки представлен бенчмарк WorldCast: 320 вручную составленных кейсов в восьми категориях. На нём проверены 12 репрезентативных моделей. Эксперименты дали три вывода. Первый: передовые модели быстро расширяют границы интеллектуального моделирования мира, GPT-Image-2.5 System набрала 72,8 и показала ранние способности к визуальному предсказанию состояний в задачах из реального мира. Второй: WorldCast выявляет существенный разрыв между моделями, даже Nano Banana Pro достигает лишь 42,8, а лучшая открытая модель набирает 20,1; слабые места, сложный контекст, переплетённые референсы и задачи, требующие рассуждений. Третий: сильные генеративные модели эффективно используют возможности своих базовых языковых моделей.
Итог авторов: нужны мультимодальные генеративные модели, которые способны к динамическому планированию и рассуждению и при этом глубоко унифицированы, чтобы достоверно имитировать состояния реального мира.
Ключевые факты
- WorldCast, бенчмарк из 320 вручную составленных кейсов в восьми категориях для многошагового предсказания состояния мира; проверено 12 моделей.
- GPT-Image-2.5 System набрала 72,8, Nano Banana Pro, 42,8, лучшая открытая модель, 20,1 (шкала и метрика в аннотации не приведены).
- Слабые места моделей по выводам авторов: сложный контекст, переплетённые референсы и задачи, требующие рассуждений.
- Сильные генеративные модели эффективно опираются на возможности своих базовых языковых моделей.
- Авторы организовали возможности моделей в четырёхуровневую иерархию и считают, что задачи верхних уровней изучены слабо.
Почему это важно
Современные мультимодальные генеративные системы способны не только создавать красивые картинки, но и показывать, как меняется мир: последовательность действий, физические преобразования, визуальные рассуждения. По оценке авторов, такие задачи высокого уровня остаются малоизученными, и WorldCast, попытка их измерить. Разрыв в результатах заметный: 72,8 у GPT-Image-2.5 System, 42,8 у Nano Banana Pro и 20,1 у лучшей открытой модели.
Кому это важно
Исследователям мультимодальных и генеративных моделей, которые ищут задачи, где текущие системы ещё слабы. Командам, выбирающим модель для сценариев, где по входным данным нужно показать последовательные будущие состояния. Тем, кто следит за отставанием открытых моделей от закрытых передовых систем в генерации изображений.
Как это применить
Это оценочная работа, а не готовый инструмент: из аннотации следует, что WorldCast можно использовать как набор задач для сравнения мультимодальных генеративных моделей по многошаговому предсказанию состояний мира. Практический ориентир для выбора моделей, приведённые три результата, но сравнивать их с другими бенчмарками напрямую нельзя: шкала и метрика в аннотации не названы.
Можно ли доверять
Источник, аннотация научной статьи, опубликованная на Hugging Face; все выводы принадлежат самим авторам бенчмарка. В аннотации не названы авторы и организации, не перечислены восемь категорий, не названа лучшая открытая модель и не указаны другие участники из 12 проверенных. Не описано, как оценивались кейсы (люди или автоматические судьи). Без полного текста статьи надёжность цифр оценить трудно.
Риски и подводные камни
Числа 72,8, 42,8 и 20,1 приведены без шкалы и метрики, поэтому их нельзя читать как проценты. Бенчмарк небольшой, 320 кейсов, составленных вручную, и измеряет конкретное понимание «предсказания состояния мира», которое задали авторы. Вывод о том, что сильные генеративные модели опираются на свои базовые языковые модели, и призыв к глубоко унифицированным моделям, позиция авторов, а не установленный факт.
«Эти выводы подчёркивают потребность в мультимодальных генеративных моделях, способных к динамическому планированию и рассуждению и при этом глубоко унифицированных, чтобы достоверно имитировать состояния реального мира.»
— Из аннотации статьи WorldCast