Авторы VLA-Δ предложили учить робота-модель на физических изменениях сцены
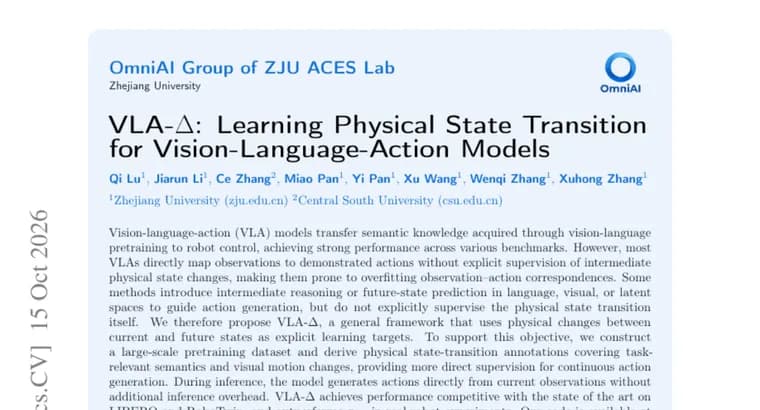
Модели «зрение-язык-действие» (VLA) переносят семантические знания, полученные при предобучении на изображениях и тексте, на управление роботами и, по словам авторов статьи, показывают сильные результаты на разных бенчмарках. Но большинство таких моделей напрямую сопоставляют наблюдения с продемонстрированными действиями, не получая явного обучающего сигнала о промежуточных физических изменениях состояния. Из-за этого, как пишут авторы, они склонны переобучаться на соответствие «наблюдение, действие».
Часть существующих методов добавляет промежуточные рассуждения или предсказание будущего состояния в языковом, визуальном или латентном пространстве, чтобы направлять генерацию действий. Однако, отмечают авторы, и они не обучают модель на самом физическом переходе между состояниями.
В ответ предложен VLA-Δ, общий фреймворк, в котором физические изменения между текущим и будущим состоянием используются как явные цели обучения. Для этого авторы собрали крупный набор данных для предобучения и вывели из него аннотации физических переходов состояния. Они охватывают семантику, важную для задачи, и визуальные изменения движения, то есть дают более прямой сигнал для генерации непрерывных действий.
При выводе модель выдаёт действия напрямую по текущим наблюдениям, без дополнительных затрат на вывод.
Результаты, по заявлению авторов: на бенчмарках LIBERO и RoboTwin VLA-Δ показывает результат, сопоставимый с лучшими существующими методами (превосходство над ними не заявлено), а в экспериментах на реальных роботах превосходит π_{0.5}. Код опубликован в репозитории ZJU-OmniAI/VLA-Delta на GitHub.
Ключевые факты
- VLA-Δ, общий фреймворк для моделей «зрение-язык-действие»: целью обучения служат физические изменения между текущим и будущим состоянием.
- Авторы собрали крупный набор данных для предобучения и вывели аннотации физических переходов, охватывающие семантику задачи и визуальные изменения движения.
- При выводе модель генерирует действия прямо по текущим наблюдениям, без дополнительных затрат на вывод.
- На LIBERO и RoboTwin результат сопоставим с лучшими методами, на реальных роботах модель превосходит π_{0.5}.
- Код доступен на GitHub: ZJU-OmniAI/VLA-Delta.
Почему это важно
Проблема, на которую указывают авторы, типична для обучения роботов по демонстрациям: модель запоминает связь «картинка, действие» и может переобучаться на неё. VLA-Δ предлагает другой сигнал, обучать модель на самом физическом переходе от текущего состояния к будущему, а не только на промежуточных рассуждениях или предсказании будущего в языковом, визуальном или латентном пространстве. Важная деталь для практики: дополнительных затрат на вывод при этом нет.
Кому это важно
Исследователям в области управления роботами и разработчикам VLA-моделей, которые ищут способы улучшить обобщение без удорожания вывода. Также тем, кто сравнивает методы на LIBERO и RoboTwin или оценивает модели на реальных роботах.
Как это применить
Код опубликован на GitHub (ZJU-OmniAI/VLA-Delta), поэтому подход можно изучить и воспроизвести. Сведений о размере модели, объёме обучающих данных и требуемых вычислительных ресурсах в тексте нет, так что оценивать затраты на обучение придётся по самому репозиторию и полной версии статьи.
Можно ли доверять
Это заявления самих авторов статьи, основанные на аннотации. Числовых результатов нет: не названы доли успешных выполнений ни на LIBERO, ни на RoboTwin, ни в экспериментах с реальными роботами. На симуляционных бенчмарках заявлена лишь сопоставимость с лучшими методами, а превосходство над π_{0.5}, только для реальных роботов. Какие именно роботы и задачи использовались, не сказано. Независимой проверки результатов в источнике нет.
Риски и подводные камни
Без цифр нельзя оценить, насколько велик выигрыш над π_{0.5} на реальных роботах и насколько он устойчив. Качество метода зависит от аннотаций физических переходов, полученных из собранного набора данных, а его размер указан лишь как «крупный». Сопоставимость с лучшими методами на бенчмарках не означает превосходства над ними.
«Во время вывода модель генерирует действия непосредственно по текущим наблюдениям без дополнительных затрат на вывод.»
— авторы статьи VLA-Δ