WhatWorkedBench: новый бенчмарк проверяет, понимают ли ИИ-агенты причины результатов своих экспериментов
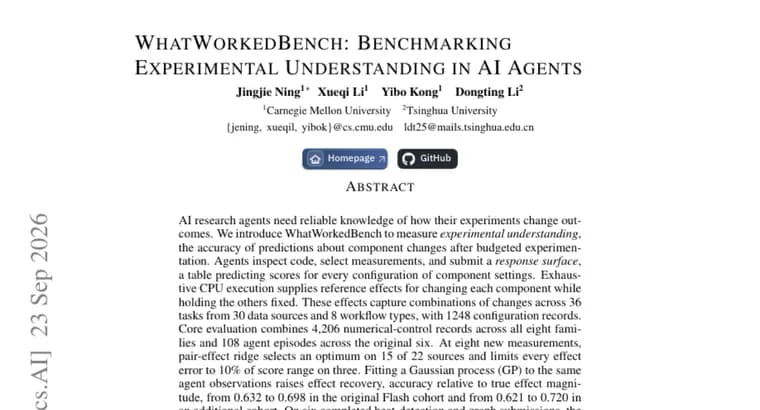
Исследователи представили бенчмарк WhatWorkedBench, который измеряет «экспериментальное понимание» ИИ-агентов, точность их предсказаний о том, как изменение отдельных компонентов эксперимента повлияет на итоговый результат, после ограниченного числа собственных проверок. Агент изучает код задачи, сам выбирает, какие измерения провести в рамках бюджета, а затем должен представить «поверхность отклика», таблицу с предсказанными результатами для всех возможных комбинаций настроек компонентов. Эталонные (истинные) значения эффектов получают путём исчерпывающего перебора на CPU: каждый компонент по очереди изменяют, оставляя остальные фиксированными, и фиксируют, как это повлияло на результат.
Бенчмарк включает 36 задач из 30 источников данных и охватывает 8 типов рабочих процессов; всего собрано 1248 записей конфигураций, фиксирующих комбинации изменений компонентов. Основная (core) оценка объединяет 4206 записей с числовыми настройками по всем восьми семействам задач и 108 эпизодов работы агентов по первоначальным шести типам рабочих процессов.
При бюджете в восемь новых измерений метод выбора по парным эффектам (pair-effect ridge) находит оптимальную конфигурацию на 15 из 22 источников, а на трёх из них ошибка предсказания эффекта не превышает 10% от диапазона возможных оценок. Если поверх тех же наблюдений агента дополнительно обучить гауссовский процесс (GP), точность восстановления эффекта, то есть соответствие истинной величине эффекта, растёт с 0,632 до 0,698 в исходной когорте Flash и с 0,621 до 0,720 в дополнительной когорте. На шести завершённых задачах по обнаружению ритма и работе с графами такое же дообучение гауссовского процесса поднимает усреднённое по семействам восстановление с 0,303 до 0,455. А на шести рабочих процессах с шестью бинарными опциями при 20 новых измерениях учёт эквивалентности кода (когда разные конфигурации дают одинаковое поведение) поднимает точность гауссовского процесса с 0,248 до 0,462.
Авторы отмечают, что WhatWorkedBench может использоваться для дальнейших исследований экспериментирующих агентов, адаптивного планирования экспериментов, численного вывода и работы с структурой программного кода.
Ключевые факты
- WhatWorkedBench включает 36 задач из 30 источников данных и 8 типов рабочих процессов, всего 1248 записей конфигураций компонентов
- Эталонные значения эффектов получают исчерпывающим перебором на CPU: каждый компонент меняют по отдельности при фиксированных остальных
- При 8 новых измерениях метод pair-effect ridge находит оптимальную конфигурацию на 15 из 22 источников и держит ошибку до 10% от диапазона оценок на трёх из них
- Дообучение гауссовского процесса на тех же наблюдениях агента повышает точность восстановления эффекта с 0,632 до 0,698 (когорта Flash) и с 0,621 до 0,720 (другая когорта)
- Учёт эквивалентности кода (одинаковое поведение разных конфигураций) поднимает точность гауссовского процесса с 0,248 до 0,462 на задачах с шестью бинарными опциями
Почему это важно
ИИ-агентов всё чаще используют для проведения экспериментов и исследовательской работы, от подбора гиперпараметров до анализа кода. Но правдоподобно выглядящий ответ агента не всегда означает, что он верно понимает причинно-следственную связь между изменением компонента и результатом. WhatWorkedBench впервые даёт строгую эталонную проверку такого понимания: за счёт исчерпывающего перебора всех комбинаций изменений на CPU авторы получают точные истинные значения эффектов, с которыми можно сравнивать предсказания агента.
Кому это важно
Бенчмарк адресован разработчикам исследовательских ИИ-агентов и специалистам по адаптивному планированию экспериментов, которые хотят проверить, действительно ли агент делает выводы из данных, а не угадывает правдоподобные цифры. Также он полезен тем, кто занимается численным выводом и анализом структуры программного кода в контексте автоматизации науки.
Как это применить
Набор данных из 1248 записей конфигураций по 36 задачам и 30 источникам можно использовать как готовый тестовый стенд для оценки собственных агентов: агенту дают бюджет на измерения (например, восемь), а затем сравнивают его предсказанную «поверхность отклика» с эталонными эффектами. Показанные в бенчмарке приёмы, выбор конфигурации по парным эффектам и дообучение гауссовского процесса поверх наблюдений агента, можно применять как способ повысить точность прогнозов без увеличения бюджета на эксперименты.
Можно ли доверять
Методология описана детально: указаны точные объёмы данных (36 задач, 30 источников, 1248 записей конфигураций, 4206 записей в основной оценке) и конкретные числовые результаты по нескольким когортам и семействам задач. При этом в самом тексте источника не названы ни авторы или организация, стоящие за бенчмарком, ни точная дата публикации, ни конкретные модели агентов, они обозначены только условными названиями когорт вроде «Flash».
Риски и подводные камни
Бенчмарк охватывает узкий набор из 36 задач и 8 типов рабочих процессов, поэтому результаты могут не обобщаться на другие виды экспериментальной работы. Метод pair-effect ridge находит оптимум лишь на 15 из 22 источников, то есть даже лучший из показанных подходов ошибается почти в трети случаев. Улучшения от гауссовского процесса и учёта эквивалентности кода заметны, но абсолютные значения точности восстановления эффекта (от 0,25 до 0,72) всё ещё далеки от надёжного уровня, что говорит об ограниченной способности агентов понимать причины результатов своих экспериментов.
«Исчерпывающее выполнение на CPU даёт эталонные эффекты для изменения каждого компонента при фиксированных остальных.»
— авторы WhatWorkedBench