DeltaWAM: модель научили предсказывать изменения кадра для роботов с двумя руками
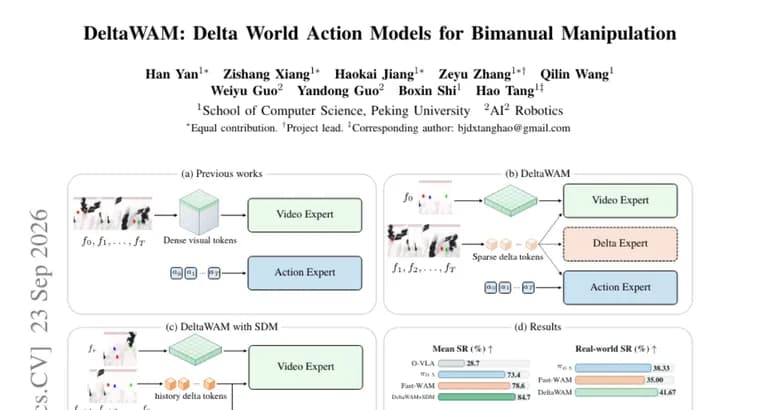
Модели мира и действий (world-action models, WAM) переносят визуальные и двигательные знания из предобученных генераторов видео на управление роботами, совместно моделируя динамику сцены и действия робота. Проблема существующих WAM в том, что во время обучения они предсказывают целиком будущие кадры, то есть повторно моделируют в основном неизменяющееся содержимое сцены и вынуждены связывать динамику, зависящую от действий, с посторонними изменениями внешнего вида (освещение, фон и так далее). При выводе (инференсе) обработка каждого полного кадра тяжёлым видео-модулем становится узким местом для быстрой генерации действий за малое число шагов.
Авторы предлагают DeltaWAM, модель, которая вместо предсказания целых будущих кадров совместно предсказывает изменения (дельты) изображения и действия робота, используя три потока данных: плотный опорный кадр (dense-anchor), разреженные дельты (sparse-delta) и поток действий. Разработаны три архитектуры, различающиеся тем, как они представляют данные и разделяют вычисления между потоками. Дополнительно предложен механизм Streaming Delta Memory (SDM, потоковая память дельт), он обновляет закешированный контекст опорного кадра компактными наблюдаемыми изменениями, что снижает нагрузку на тяжёлый видео-модуль.
На бенчмарке RoboTwin DeltaWAM с SDM повысил среднюю долю успешных попыток по сравнению с базовой моделью Fast-WAM с 81,3% до 85,4% в «чистых» условиях и с 75,8% до 83,9% при визуальной рандомизации (случайных изменениях внешнего вида сцены). Три предложенные архитектуры снижают затраты вычислений (FLOPs) на обучение на 17,78, 23,77%, а SDM снижает задержку и вычислительные затраты одного шага инференса на 36,57% и 31,55% соответственно. В реальных экспериментах DeltaWAM также показал наивысшую долю успешных попыток и наилучший нормализованный прогресс среди сравниваемых политик управления. Код и материалы проекта авторы выложили в открытый доступ на GitHub и на сайте проекта.
Ключевые факты
- DeltaWAM предсказывает не целые будущие кадры, а только изменения (дельты) изображения вместе с действиями робота, через три потока: опорный кадр, разреженные дельты и действия
- Механизм Streaming Delta Memory (SDM) обновляет закешированный контекст компактными изменениями вместо повторной обработки полного кадра тяжёлым видео-модулем
- На бенчмарке RoboTwin точность выросла с 81,3% до 85,4% в чистых условиях и с 75,8% до 83,9% при визуальной рандомизации по сравнению с базовой моделью Fast-WAM
- Обучение стало дешевле на 17,78, 23,77% по вычислениям, а SDM снизил задержку инференса на 36,57% и вычисления на 31,55%
- В реальных экспериментах с роботами DeltaWAM показал лучшую долю успешных попыток среди сравниваемых подходов; код опубликован на GitHub
Почему это важно
Модели мира и действий позволяют роботам переносить визуальные и двигательные знания из больших видео-генераторов на управление манипуляторами, но раньше это требовало предсказывать целые будущие кадры, дорого и медленно. DeltaWAM показывает, что можно предсказывать только изменения сцены, а не весь кадр целиком, и получать от этого одновременно точность выше и вычисления дешевле, и при обучении, и при выводе.
Кому это важно
Разработчикам робототехнических систем и исследователям, работающим с манипуляторами с двумя руками (бимануальными роботами), а также авторам моделей мира и действий, которые ищут способы ускорить инференс без потери качества управления.
Как это применить
Код DeltaWAM и материалы проекта выложены в открытом доступе на GitHub и на отдельном сайте проекта, что позволяет воспроизвести архитектуру и механизм Streaming Delta Memory или адаптировать их под собственные задачи бимануального манипулирования.
Можно ли доверять
Результаты представлены как численное сравнение на общепринятом бенчмарке RoboTwin в двух условиях (чистая сцена и визуальная рандомизация), а также в реальных экспериментах с роботами, с указанием конкретных цифр прироста точности и снижения вычислительных затрат. В доступном тексте источника не названы авторы, их организации, дата публикации и конкретные роботы или задачи, использованные в реальных тестах, это делает независимую проверку деталей ограниченной.
Риски и подводные камни
Указан только диапазон улучшений на одном бенчмарке и в реальных тестах без детального описания использованных задач и оборудования, поэтому неясно, насколько эти результаты обобщаются на другие сценарии бимануального манипулирования и на роботов с иной конструкцией.
«Существующие модели мира и действий предсказывают плотные будущие кадры во время обучения, многократно моделируя в основном неизменный контент и связывая динамику, обусловленную действиями, с посторонними изменениями внешнего вида.»
— из текста статьи