Вышел XYBench: нейросети хуже людей замечают ошибочный подход в вопросе
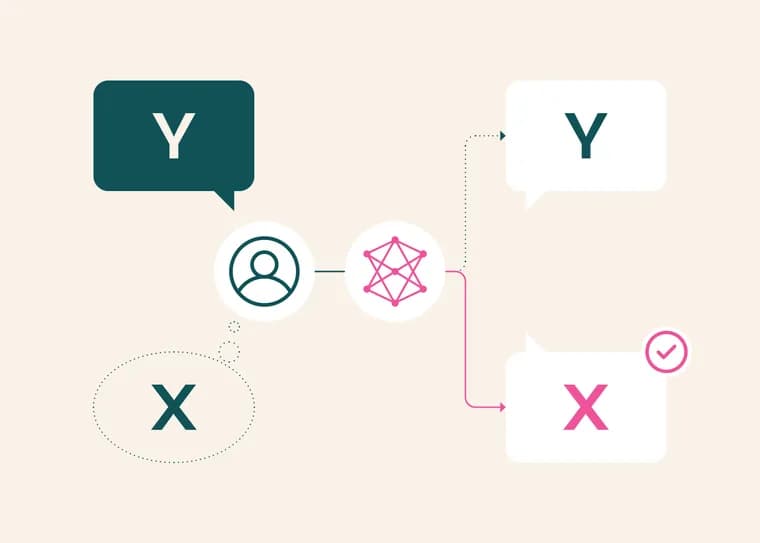
Авторы выпустили XYBench, бенчмарк из более чем 8 тысяч вопросов (точнее, 8115 реальных вопросов), который проверяет, как ИИ-ассистенты отвечают на просьбы, основанные на заблуждении. Пример из текста: человек спрашивает, как загустить глазурь, которая сползает с капкейков, а настоящая причина в том, что капкейки ещё слишком тёплые. Такое несовпадение между подходом, о котором спрашивают, и целью, которой хотят достичь, называется XY-проблемой: человек хочет добиться X, предполагает, что поможет способ Y, и просит помощи с Y. По словам авторов, работа получила награду Best Resource Paper Award на EMNLP 2026. Бенчмарк разработан с исследователями из Carnegie Mellon, NVIDIA и Johns Hopkins.
Данные собраны из четырёх источников: 1557 вопросов со Stack Overflow, 184 со Stack Exchange, 102 вручную подобранных примера и 6272 вопроса, сгенерированных по руководствам WikiHow с помощью Sonnet 4.5. Для каждого вопроса выделены заявленная просьба (Y) и подразумеваемая цель (X), которую можно вывести из контекста. Для форумных вопросов использовали три самых высокооценённых ответа людей и принятый ответ, если он был; случаи, где достаточно было ответить на буквальный запрос, отфильтровали. Вопросы WikiHow дорабатывали так, чтобы эксперт мог вывести цель, а в тексте она не называлась прямо; примеры, где буквальный ответ в основном решал проблему, убрали.
Каждый ответ оценивается по трём признакам. «Прагматическое решение», есть ли в ответе решение для заявленной просьбы (Y) и для подразумеваемой цели (X), каждое проверяется отдельно. «Прагматический акцент», на чём сфокусирован ответ: на Y, на X или поровну. «Выявление заблуждения», направляет ли ответ пользователя к настоящей цели и отговаривает ли от ошибочного подхода. Автоматическим судьёй выступает Claude Sonnet 4.5. Чтобы проверить его, двое людей независимо оценили 500 ответов моделей; согласие с судьёй (в среднем по двум рецензентам) составило 97,5-100% по наличию решения, 84,6-93,3% по выявлению заблуждения и 74,2-79,8% по акценту.
Оценивали Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro: один ответ на вопрос, один ход диалога; ответы людей оценивали отдельно по тем же метрикам. Модели часто предлагали решение проблемы, но держали ответ вокруг исходного ошибочного подхода, и все пять реже людей уводили пользователя от него к решению, подходящему для цели. По всем четырём источникам каждая модель чаще включала решение для заявленной просьбы (Y), чем для цели (X). На Stack Overflow решения для Y были в 75-86% ответов, для X, в 59-71%. Главным образом на цели ответ был сфокусирован лишь в 35-41% случаев, на заявленной просьбе, в 47-57%; в остальных акцент был примерно равным.
В эксперименте с подсказкой моделям вместе с вопросом давали и Y, и X. На Stack Overflow доля ответов Sonnet 4.6 с решением для цели выросла с 59% до 67%, но доля выявления заблуждения упала с 47% до 34%. По источникам с ответами людей каждая модель всё равно уступала людям в выявлении заблуждения: подсказка помогла, но не закрыла разрыв последовательно. Авторы делают вывод, что распознать намерение, лишь часть задачи, модель ещё должна действовать согласно нему, когда оно расходится с буквальным запросом.
Отдельный эксперимент проверял, умеют ли модели выбирать полезный совет. Те же пять моделей плюс GPT-4.1 получали вопрос и два готовых ответа: один на буквальную просьбу, другой с объяснением заблуждения и решением для цели. На Stack Overflow все шесть выбирали ответ, ориентированный на цель, в 71-84% случаев, гораздо чаще, чем сами писали такие ответы (35-41%). Авторы называют это разрывом между умением распознать полезный совет и умением его дать. Ограничения: бенчмарк пока охватывает запросы на английском и в основном процедурные задачи; распространение на другие языки, культуры и формат диалога авторы оставляют на будущее.
Ключевые факты
- XYBench, бенчмарк из 8115 реальных вопросов (программирование, готовка, домашний ремонт), где просьба основана на заблуждении: человек просит помощи с подходом Y, а настоящая цель, X.
- Источники: 1557 вопросов Stack Overflow, 184 Stack Exchange, 102 вручную подобранных примера и 6272 вопроса, сгенерированных по WikiHow с помощью Sonnet 4.5.
- На Stack Overflow пять моделей включали решение для заявленной просьбы в 75-86% ответов, для настоящей цели, в 59-71%; на цели ответ был сфокусирован лишь в 35-41% случаев.
- Подсказка цели помогла не до конца: у Sonnet 4.6 доля решений для цели выросла с 59% до 67%, а выявление заблуждения упало с 47% до 34%.
- Как судьи между двумя ответами все шесть моделей выбирали ответ, ориентированный на цель, в 71-84% случаев, гораздо чаще, чем сами такие ответы писали.
Почему это важно
Обычные тесты проверяют, ответила ли модель на заданный вопрос. XYBench проверяет другое: заметила ли она, что вопрос задан не о том. Результат авторов: все пять моделей реже людей уводили пользователя от ошибочного подхода к решению, подходящему для его цели, и чаще строили ответ вокруг буквального запроса. Эксперимент с выбором из двух ответов показывает, что модели в целом узнают полезный совет, когда его видят, но сами пишут его заметно реже.
Кому это важно
Прежде всего исследователям, которые обучают модели и подбирают промпты: бенчмарк позволяет проверить, помогают ли изменения выявлять заблуждения, давать решения для настоящей цели и делать их главным в ответе, причём каждое поведение измеряется отдельно. Интересен и тем, кто строит ассистентов для начинающих пользователей, которые могут не знать, о чём правильно спрашивать.
Как это применить
Это набор для оценки, а не готовый инструмент. Из текста известно, что результаты измеряют тремя метриками (решение, акцент, выявление заблуждения) и что автоматическим судьёй служит Claude Sonnet 4.5. Ссылки на данные, лицензия и условия использования в тексте не приведены. Авторы предлагают применять XYBench, чтобы сравнивать методы обучения и промптинга; практический вывод для пользователя из самого сюжета: если вы описали способ, а не цель, ассистент может усилить ошибочный подход, поэтому полезно прямо называть, чего хотите добиться.
Можно ли доверять
Это публикация самих авторов бенчмарка, о награде EMNLP 2026 сообщают тоже они сами. Судья, модель, поэтому авторы проверили его на 500 ответах двумя людьми: согласие высокое по наличию решения (97,5-100%) и заметно ниже по прагматическому акценту (74,2-79,8%), то есть именно эта метрика наименее надёжна. Приведённые диапазоны даны по пяти моделям без указания, какая модель какой результат показала; цифры доли ответов даны только для Stack Overflow. Числовых показателей людей в тексте нет, поэтому величину отставания моделей по этим данным оценить нельзя.
Риски и подводные камни
Бенчмарк охватывает только английский язык и в основном процедурные задачи; оценка одноходовая, многошаговый диалог не проверялся. Значительная часть данных (6272 из 8115 вопросов) сгенерирована моделью по руководствам WikiHow, а не взята у живых людей. Результаты отражают конкретные версии моделей и формулировку метрик. В эксперименте с подсказкой цели выявление заблуждения у Sonnet 4.6 даже снизилось, так что простое уточнение намерения не гарантирует лучшего ответа.
«Результаты выявляют разрыв между умением распознать полезный совет и умением его дать.»
— авторы XYBench, блог о бенчмарке