Выбор токенизатора изображений может повлиять на то, как модель работает с текстом
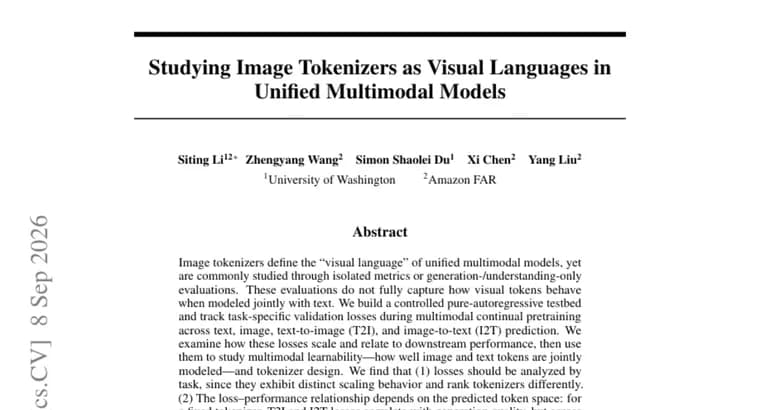
Токенизатор изображений превращает картинку в последовательность дискретных токенов, то есть задаёт для модели её «визуальный язык». В объединённых (unified) мультимодальных моделях, где генерация и понимание текста и изображений происходит в одном общем авторегрессионном ядре, качество этого «языка» обычно оценивают либо общими метриками реконструкции, насколько точно токенизатор восстанавливает исходную картинку по своим токенам, либо отдельными бенчмарками генерации и отдельными бенчмарками понимания. По словам авторов новой работы, такие оценки не показывают, как визуальные токены на самом деле ведут себя, когда их обучают совместно с текстом, а именно в таком совместном режиме объединённые модели и работают на практике.
Ситин Ли с соавторами построили контролируемый испытательный стенд на чисто авторегрессионной архитектуре и в ходе непрерывного мультимодального предобучения отслеживали специфичные для задачи потери на валидации по четырём направлениям: по тексту, по изображениям, по генерации изображения из текста (T2I) и по генерации текста по изображению (I2T). По тому, как эти потери масштабируются и связаны с итоговым качеством модели, авторы изучили «мультимодальную обучаемость», то есть насколько хорошо изображение и текст поддаются совместному моделированию, и то, как на неё влияет устройство самого токенизатора.
Основных наблюдений четыре. Во-первых, потери нужно анализировать по каждой задаче отдельно: у них разное поведение при масштабировании, и один и тот же набор токенизаторов они ранжируют между собой по-разному, лидер по одной задаче необязательно лидирует и по другой. Во-вторых, связь между величиной потери и итоговым качеством зависит от того, в каком пространстве токенов она считается: для одного фиксированного токенизатора потери T2I и I2T коррелируют с качеством генерации, но при сравнении разных токенизаторов между собой связь потери T2I с качеством сдвигается вместе с пространством токенов конкретного токенизатора, тогда как потеря I2T, она считается по словарю, общему с текстом, даёт более устойчивый сигнал; после дообучения с учителем та же потеря I2T коррелирует уже и с качеством генерации, и с качеством визуального понимания.
Третье и четвёртое наблюдения касаются устройства самого токенизатора. Более точная реконструкция изображения не обязательно означает более низкие потери по конкретным задачам или более сильный итоговый результат, то есть привычная метрика реконструкции может вводить в заблуждение при выборе токенизатора для объединённой модели. А выбор токенизатора изображений, по данным авторов, способен повлиять даже на то, как модель моделирует текст, когда её обучают совместно на двух модальностях, эффект пересекает границу модальностей.
Используя эти потери как инструмент анализа, авторы в качестве примера пересмотрели три параметра устройства токенизатора: дискриминатор (компонент, который отвечает за состязательное обучение токенизатора), семантическую привязку (обучение с оглядкой на смысл изображения, а не только на его пиксели) и размер словаря токенов, чтобы посмотреть, как каждый из них сказывается на совместном моделировании текста и изображений и на итоговом качестве.
Аннотация не называет ни конкретных токенизаторов для сравнения, ни численных значений потерь или итогового качества, ни организации, которая провела работу, ни имён соавторов помимо первого; по отдельным метаданным (не по самому тексту) известен только первый автор, Ситин Ли.
Ключевые факты
- Ситин Ли с соавторами построили контролируемый испытательный стенд на чисто авторегрессионной архитектуре и в ходе непрерывного мультимодального предобучения отслеживали специфичные для задачи потери на валидации по четырём направлениям, тексту, изображениям, генерации изображения из текста (T2I) и генерации текста по изображению (I2T).
- Потери по разным задачам масштабируются по-разному и по-разному ранжируют одни и те же токенизаторы между собой, по выводу авторов, анализировать их нужно раздельно по задачам, а не одной сводной метрикой.
- Связь потери с итоговым качеством зависит от пространства токенов: при сравнении разных токенизаторов потеря T2I смещается вместе с пространством токенов конкретного токенизатора, тогда как потеря I2T (на общем с текстом словаре) даёт более устойчивый сигнал и после дообучения с учителем коррелирует и с генерацией, и с визуальным пониманием.
- Более точная реконструкция изображения токенизатором не обязательно даёт более низкие потери по задачам или более сильный итоговый результат; при этом выбор токенизатора изображений способен повлиять даже на то, как модель моделирует текст при совместном обучении.
- В качестве примера авторы пересмотрели три параметра устройства токенизатора, дискриминатор (состязательный компонент обучения), семантическую привязку (обучение с оглядкой на смысл изображения, а не только пиксели) и размер словаря токенов; аннотация не называет ни конкретных цифр, ни токенизаторов-базлайнов, ни соавторов помимо первого.
Почему это важно
Токенизатор изображений задаёт «визуальный язык» для моделей, которые одним общим авторегрессионным ядром и понимают, и генерируют текст и картинки. До сих пор такие токенизаторы обычно сравнивали либо по тому, насколько точно они восстанавливают исходное изображение (реконструкция), либо по отдельным бенчмаркам, только генерации или только понимания, а это не показывает, как визуальные токены ведут себя, когда их обучают совместно с текстом, то есть именно в том режиме, в котором объединённые модели и работают. Работа предлагает более прямой инструмент, специфичные для задачи потери при совместном обучении, и с его помощью показывает две вещи, которые ломают интуицию: привычная метрика реконструкции токенизатора не гарантирует ни более низкие потери на реальных задачах, ни более высокое итоговое качество модели, а выбор токенизатора изображений способен незаметно повлиять даже на то, как модель работает с текстом.
Кому это важно
Тем, кто проектирует или обучает объединённые мультимодальные модели, с единым авторегрессионным ядром для текста и изображений, и должен выбрать или спроектировать для неё токенизатор изображений: работа предупреждает, что метрика реконструкции сама по себе решение не подскажет. Исследователям, которые сравнивают токенизаторы между собой, предлагает более надёжный сигнал: потерю I2T на общем с текстом словаре, вместо разрозненных бенчмарков генерации и понимания. И тем, кто отвечает за качество текстовой части объединённой модели, предупреждение, что на него способен повлиять даже, казалось бы, не связанный с текстом выбор визуального компонента.
Как это применить
Практический вывод работы, сравнивать и настраивать токенизаторы изображений не по тому, насколько точно они восстанавливают картинку, а по специфичным для задачи потерям при совместном обучении с текстом. Самый устойчивый из них, по данным авторов, потеря I2T (генерация текста по изображению), посчитанная на словаре, общем с текстом: она же после дообучения с учителем коррелирует и с качеством генерации изображений, и с качеством визуального понимания. При выборе или пересмотре конкретной реализации токенизатора стоит отдельно проверять эффект на трёх параметрах, которые разбирают авторы, дискриминаторе, семантической привязке и размере словаря токенов, поскольку каждый из них способен сдвинуть и совместное моделирование, и итоговое качество. Отдельно стоит проверять текстовые способности итоговой модели при смене токенизатора изображений, а не только качество работы с картинками, по данным авторов, эффект способен пройти именно через текст. Это диагностический метод и предупреждение для дизайна токенизатора, а не готовый рецепт: конкретных числовых значений потерь, порогов или названий протестированных токенизаторов аннотация не приводит.
Можно ли доверять
Источник, аннотация научной статьи (судя по номеру 2609.09143, arXiv-препринт), опубликованная на Hugging Face Papers; результаты не проходили независимую проверку или рецензирование на момент публикации аннотации. Все четыре ключевых наблюдения, аналитические выводы самих авторов по итогам собственного эксперимента, без единой опорной цифры: ни величин потерь, ни процента прироста итогового качества, ни названий конкретных токенизаторов или бенчмарков аннотация не приводит. Текст не называет ни организацию, которая провела исследование, ни имена соавторов; по отдельным метаданным (не по самому тексту аннотации) известен только первый автор, Ситин Ли. Экспериментальная схема, контролируемый стенд с потерями по четырём типам задач на протяжении предобучения, описана как систематическая проверка, а не единичный замер, но проверить её результаты по одной аннотации, без доступа к полному тексту статьи, нельзя.
Риски и подводные камни
Все выводы получены на «чисто авторегрессионном» испытательном стенде, неизвестно, переносятся ли они на мультимодальные модели другой архитектуры (например, с диффузионной генерацией изображений), которые стенд не охватывает. Три параметра токенизатора, дискриминатор, семантическая привязка и размер словаря, разобраны как категории, а не как конкретные протестированные конфигурации, поэтому воспроизвести сравнение по одной аннотации нельзя. Эффект «выбор токенизатора влияет на моделирование текста» заявлен без указания силы и механизма, неясно, идёт ли речь о заметной деградации языковых способностей или о небольшом статистическом сдвиге. Наконец, вывод о том, что реконструкция не предсказывает итоговое качество, может зависеть от масштаба модели и объёма данных предобучения, которые аннотация не приводит.
«Выбор токенизатора изображений способен повлиять на моделирование текста при совместной оптимизации.»
— авторы исследования