VisionWeave сокращает визуальные токены нейросетей на 43% в среднем
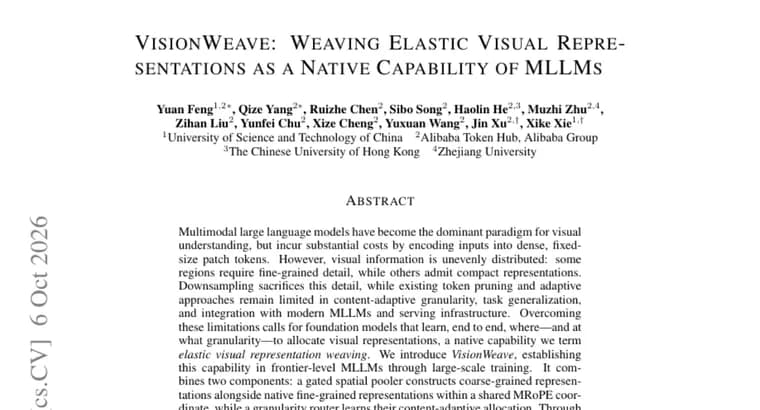
Мультимодальные большие языковые модели (MLLM) стали основным подходом к пониманию изображений, но обходятся дорого: вход кодируется в плотные патч-токены фиксированного размера. Авторы статьи отмечают, что визуальная информация распределена неравномерно: одним областям нужна мелкая детализация, другим хватает компактного представления. Простое уменьшение разрешения теряет детали, а существующие методы отсечения токенов и адаптивные подходы, по оценке авторов, ограничены в адаптивности к содержимому, в обобщении на разные задачи и в интеграции с современными MLLM и инфраструктурой обслуживания.
Ответ авторов, метод VisionWeave. Идея в том, чтобы модель сама, сквозным обучением, училась, где и с какой детализацией выделять визуальные представления; эту способность авторы называют «эластичным визуальным плетением» (elastic visual representation weaving). Метод состоит из двух частей: управляемый (gated) пространственный пулер строит грубые представления рядом с исходными мелкими в общей координатной системе MRoPE, а маршрутизатор гранулярности (granularity router) учится распределять их в зависимости от содержимого.
Обучение велось только самодистилляцией: сначала способность проверили на Qwen3.5-4B, затем масштабировали на Qwen3.8-27B, потратив более 30 тысяч GPU-часов A100. На Qwen3.8-27B VisionWeave подстраивает экономию токенов под содержимое изображения: в среднем экономится 43,0% токенов, при этом удерживается 98,9% нативной (исходной) производительности по восьми бенчмаркам. Для сравнения, базовые методы отсечения токенов с фиксированной целью экономии 50% сохраняют лишь 88% производительности. Авторы утверждают, что оценки подтверждают устойчивый компромисс между эффективностью и качеством на разных задачах, разрешениях и числе видеокадров.
При развёртывании на движке обслуживания SGLang метод даёт рост пропускной способности в 2,3 раза, снижая среднее время до первого токена (TTFT) на 54,4%, а среднее время на выходной токен (TPOT) на 60,6%. Авторы полагают, что результаты делают эластичное визуальное «плетение» многообещающей способностью для мультимодальных моделей следующего поколения.
Ключевые факты
- VisionWeave состоит из управляемого пространственного пулера (грубые и мелкие представления в общей координате MRoPE) и маршрутизатора гранулярности, который учится распределять их по содержимому.
- На Qwen3.8-27B в среднем экономится 43,0% токенов при сохранении 98,9% нативной производительности по восьми бенчмаркам.
- Базовые методы отсечения токенов с фиксированной целью экономии 50% сохраняют лишь 88% производительности.
- Обучение только самодистилляцией: проверка на Qwen3.5-4B, масштабирование на Qwen3.8-27B за более чем 30 тысяч GPU-часов A100.
- На SGLang пропускная способность выше в 2,3 раза, среднее время до первого токена (TTFT) ниже на 54,4%, среднее время на выходной токен (TPOT) ниже на 60,6%.
Почему это важно
Заметные расходы мультимодальных моделей связаны с плотными визуальными токенами фиксированного размера. VisionWeave предлагает не отсекать токены внешним приёмом, а встроить в саму модель умение решать, какие области изображения кодировать подробно, а какие грубо. По заявленным цифрам это даёт заметную экономию (в среднем 43,0% токенов) почти без потери качества (98,9% нативной производительности) и ощутимый выигрыш при обслуживании: 2,3 раза по пропускной способности на SGLang.
Кому это важно
Командам, которые разворачивают мультимодальные модели и платят за обработку изображений и видео, а также тем, кто сам обучает такие модели и ищет способ сократить визуальный вход. Отдельно интересен результат для SGLang: метод заявлен как совместимый с современной инфраструктурой обслуживания.
Как это применить
Это не готовая настройка, а способ дообучения: возможность встраивается в модель крупным обучением (для Qwen3.8-27B, более 30 тысяч GPU-часов A100) и проверена на двух моделях семейства Qwen. В аннотации ничего не сказано о публикации кода или весов, поэтому практическая применимость пока зависит от того, будут ли они выложены.
Можно ли доверять
Это препринт, и все цифры, собственные результаты авторов. В тексте аннотации не названы ни авторы и организации, ни восемь бенчмарков, ни базовые методы отсечения токенов, поэтому сравнение с 88% проверить не по чему. Экономия токенов у VisionWeave (43,0% в среднем) и у базовых методов (фиксированные 50%) приведена на разных уровнях. Условия измерений на SGLang (оборудование, нагрузка) не описаны.
Риски и подводные камни
98,9% и 88%, это доля от нативной производительности, абсолютные баллы не приведены, а 43,0%, среднее значение, так что по ним нельзя судить о результатах на отдельных задачах. Цена внедрения высока: обучение крупной версии потребовало более 30 тысяч GPU-часов A100. Результаты описаны на моделях Qwen3.5-4B и Qwen3.8-27B; перенос на другие модели в тексте не показан. Утверждение о перспективности подхода, убеждение самих авторов, а не доказанный факт.
«Мы полагаем, что эти результаты делают эластичное визуальное «плетение» многообещающей способностью для мультимодальных моделей следующего поколения.»
— авторы статьи о VisionWeave