Video-Coder: агент пишет код 3D-сцены, чтобы улучшить генерацию видео
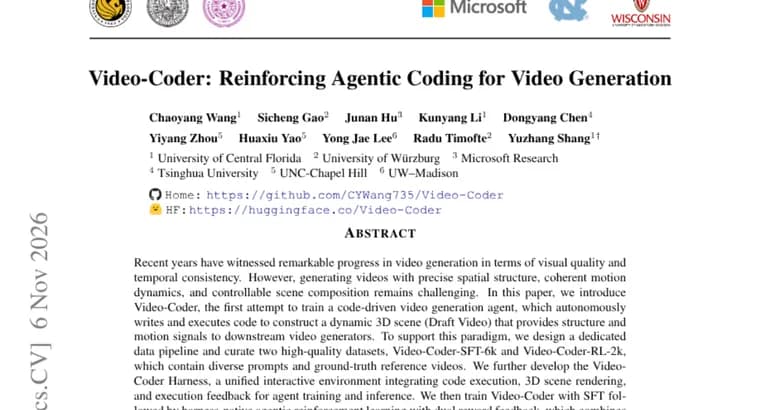
Авторы статьи исходят из того, что генерация видео заметно продвинулась в визуальном качестве и согласованности во времени, но точная пространственная структура, связная динамика движения и управляемая композиция сцены по-прежнему даются тяжело.
В ответ они предлагают Video-Coder, по их словам, первую попытку обучить агента для генерации видео через код. Агент самостоятельно пишет и исполняет код, который строит динамическую 3D-сцену, «черновое видео» (Draft Video). Эта сцена даёт нижестоящим генераторам видео сигналы о структуре и движении.
Для такого подхода авторы построили специальный конвейер данных и собрали два набора: Video-Coder-SFT-6k и Video-Coder-RL-2k. В них есть разнообразные промпты и эталонные видео. Кроме того, создана среда Video-Coder Harness, единая интерактивная среда, где объединены исполнение кода, рендеринг 3D-сцены и обратная связь от исполнения; она служит и для обучения, и для работы агента.
Обучение идёт в два этапа: сначала SFT (обучение на размеченных примерах), затем агентное обучение с подкреплением прямо внутри этой среды с двойной наградой. Одна часть награды основана на исполнении кода, другая, на оценке получившегося видео. Дополнительно применена стратегия «отжига»: награда за исполнение постепенно снижается, и на поздних этапах модель опирается в основном на награду за видео.
По заявлению авторов, Video-Coder даёт существенный прирост: Minimax-H3 улучшается примерно на 7 пунктов на PhyGenBench и на 24 пункта на VBench-2.0. Авторы говорят, что полностью открывают данные, модели и код, и надеются, что работа станет открытой основой для агентов-программистов в генерации видео.
Ключевые факты
- Video-Coder, агент, который пишет и исполняет код, строя динамическую 3D-сцену (Draft Video) со сведениями о структуре и движении для генераторов видео; авторы называют это первой такой попыткой обучения.
- Собраны два набора данных: Video-Coder-SFT-6k и Video-Coder-RL-2k, а также среда Video-Coder Harness с исполнением кода, 3D-рендерингом и обратной связью.
- Обучение: SFT, затем агентное обучение с подкреплением с двойной наградой (за исполнение кода и за видео); награда за исполнение со временем снижается.
- Заявленный результат: Minimax-H3 лучше примерно на 7 пунктов на PhyGenBench и на 24 пункта на VBench-2.0.
- Авторы заявляют, что полностью открывают данные, модели и код.
Почему это важно
Генераторы видео всё лучше справляются с картинкой, но точная геометрия сцены, согласованное движение и управление композицией остаются слабым местом. Video-Coder предлагает обходной путь: сначала агент строит в коде простую динамическую 3D-сцену, и уже она подсказывает генератору структуру и движение. Это любопытный пример того, как кодирующие агенты применяют вне привычной разработки ПО.
Кому это важно
Исследователям генерации видео и агентного обучения с подкреплением, а также командам, которые строят управляемые видеопайплайны и хотят явно задавать композицию и движение. Тем, кто следит за открытыми наборами данных и средами для обучения агентов, тоже стоит присмотреться.
Как это применить
Пока это исследовательская работа. Авторы заявляют, что открывают данные, модели и код, поэтому при желании подход можно воспроизвести или взять за основу для своих экспериментов. Прежде чем строить на нём что-то серьёзное, стоит проверить, что именно опубликовано: в тексте аннотации нет ссылок и лицензий на выложенные материалы.
Можно ли доверять
Все цифры взяты из аннотации и сообщены самими авторами. В аннотации не названы ни авторы, ни организации, не указаны базовые значения на PhyGenBench и VBench-2.0, поэтому итоговые абсолютные оценки неизвестны. Не сказано и то, что такое Minimax-H3 помимо названия, и нет сравнения с другими системами генерации видео. Формулировка «первая попытка», самооценка авторов.
Риски и подводные камни
Прирост в «пунктах» приведён без исходных значений, поэтому понять его реальный масштаб нельзя. В аннотации не указаны вычислительные затраты, время обучения, размер модели и базовая модель Video-Coder. Результат показан для Minimax-H3; насколько он переносится на другие генераторы видео, из текста не ясно. Открытость данных, моделей и кода пока остаётся заявлением авторов.
«Мы надеемся, что эта работа сможет стать открытой основой для кодирующих агентов в генерации видео.»
— авторы статьи Video-Coder, аннотация