VC-Attention ускоряет низкобитное внимание видео-моделей в 1,46, 3,6 раза
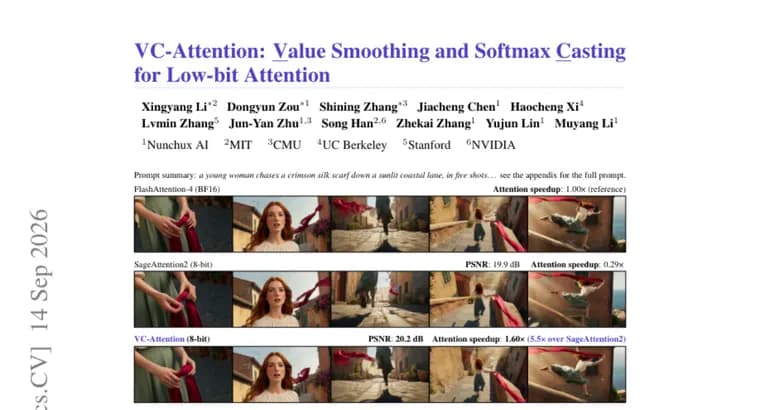
Диффузионные трансформеры (DiT) дают лучшее качество генерации видео, но из-за длинных пространственно-временных последовательностей вычисление внимания (attention) становится главной статьёй затрат при развёртывании. Чтобы низкобитный (сжатый до пониженной разрядности) kernel внимания был практичен, он должен быть одновременно точным и быстрым.
Точность ограничивают выбросы (outliers): масштаб квантования блока задаётся его крупнейшими значениями, из-за чего типичные значения оказываются втиснуты в узкий диапазон представимых чисел. Прежние методы сглаживают запросы (queries) и ключи (keys), но выбросы в значениях (values) не подчиняются фиксированной структуре по каналам или по пространству-времени и остаются главным источником ошибки на выходе.
Скорость ограничивает softmax: низкобитные тензорные ядра (Tensor Cores) ускоряют только два матричных умножения внутри attention, а высокоточная экспонента между ними становится самым долгим этапом конвейера на датацентровых GPU.
Авторы предлагают VC-Attention, не требующий дообучения (training-free) фреймворк низкобитного внимания, который сочетает два приёма: V-Smooth и ExpCast-FP8. V-Smooth переупорядочивает токены значений лёгкой онлайн-кластеризацией, чтобы токены внутри одного аппаратного блока квантовались согласованно; он квантует только остаток после вычитания среднего по блоку, а само среднее восстанавливает из суммы по строке, которую и так поддерживает онлайн-softmax. ExpCast-FP8 переводит оценки из лог-домена напрямую в коды вероятности формата E4M3 одной слитной операцией умножения-сложения, убирая и экспоненту в FP32, и отдельное преобразование формата.
Метод реализован для GPU B200, B300, H200, RTX PRO 6000 и RTX 5090. На четырёх моделях генерации видео, Wan2.2, LongCat-Video, HunyuanVideo-1.5 и MiniMax-H3, VC-Attention повышает точность (fidelity) по сравнению с низкобитными baseline-методами (числовая метрика в источнике не приведена) и ускоряет ядро attention относительно BF16-версии FlashAttention-4: в 1,46, 1,59 раза на датацентровых GPU архитектур Blackwell и Hopper и в 2,3, 3,6 раза на картах для рабочих станций. Генерация целого клипа ускоряется в 1,13, 1,19 раза и в 1,36, 1,70 раза, источник не уточняет, какой из этих двух диапазонов относится к датацентровым GPU, а какой к рабочим станциям.
Ключевые факты
- VC-Attention, не требующий дообучения фреймворк низкобитного внимания для видео-трансформеров, сочетающий V-Smooth и ExpCast-FP8
- V-Smooth переупорядочивает токены значений онлайн-кластеризацией и квантует только остаток после вычитания среднего по блоку
- ExpCast-FP8 одной слитной операцией переводит оценки в коды E4M3, убирая FP32-экспоненту и отдельное преобразование формата
- Ядро attention ускоряется относительно BF16 FlashAttention-4 в 1,46, 1,59 раза на датацентровых GPU (Blackwell, Hopper) и в 2,3, 3,6 раза на картах для рабочих станций
- Проверено на GPU B200, B300, H200, RTX PRO 6000, RTX 5090 и моделях Wan2.2, LongCat-Video, HunyuanVideo-1.5, MiniMax-H3; генерация целого клипа быстрее в 1,13, 1,19 и 1,36, 1,70 раза
Почему это важно
В генерации видео на диффузионных трансформерах attention, главная статья затрат из-за длинных пространственно-временных последовательностей. Низкобитное квантование этого узла упирается сразу в две проблемы: выбросы в значениях портят точность, а высокоточная экспонента softmax, которую низкобитные тензорные ядра не ускоряют, становится самым долгим этапом конвейера. VC-Attention решает обе проблемы одним фреймворком и без дообучения модели.
Кому это важно
Тем, кто разворачивает диффузионные видео-модели в продакшне и считает стоимость инференса на GPU, и на серверных картах датацентров (B200, B300, H200), и на картах для рабочих станций (RTX PRO 6000, RTX 5090). Метод адресован именно инженерному звену: ускорению уже готовых моделей на конкретном железе, а не обучению новых.
Как это применить
VC-Attention не требует дообучения модели, это оптимизация на уровне вычислительного ядра, применимая к уже готовой видео-модели при инференсе. Авторы реализовали её для пяти конкретных GPU (B200, B300, H200, RTX PRO 6000, RTX 5090) и проверили на четырёх моделях генерации видео. Источник не сообщает о публикации кода, лицензии или сроках интеграции в существующие фреймворки инференса, об этом судить рано.
Можно ли доверять
Материал, научная публикация (страница HuggingFace Papers) с 35 отметками и 2 комментариями, все заявления о превосходстве метода принадлежат самим авторам, независимой проверки в тексте нет. Улучшение точности (fidelity) над низкобитными базовыми методами заявлено качественно, без числовой метрики (PSNR, ошибки и т.п.), то есть насколько именно улучшилась точность, по источнику не определить.
Риски и подводные камни
Главный пробел, отсутствие числовой оценки точности: заявлено, что fidelity выше, чем у низкобитных baseline, но насколько именно, не сказано. Источник также не уточняет, какому классу GPU (датацентровому или рабочей станции) соответствует каждый из двух диапазонов ускорения полной генерации клипа. Результаты получены на четырёх конкретных моделях и пяти конкретных GPU, обобщение на другое железо и другие архитектуры видео-моделей источником не подтверждено.