VA-Bench: новый бенчмарк выявил провал ИИ в пространственных задачах
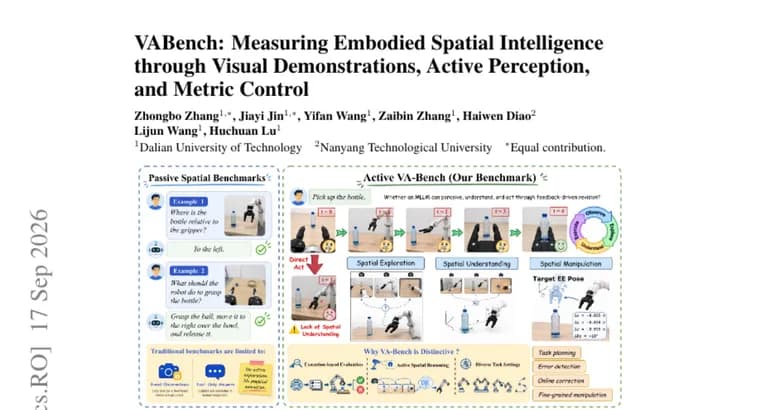
Исследователи представили VA-Bench, бенчмарк для проверки пространственного мышления мультимодальных ИИ-моделей (MLLM) в условиях неполного наблюдения. В отличие от предыдущих тестов, VA-Bench не даёт моделям привилегированной информации: ни точных координат объектов, ни эталонных траекторий движения, ни заранее обученных модулей действия. Модель должна сама пройти полный цикл «наблюдение, рассуждение, действие, коррекция»: по RGB-демонстрациям понять контекст задачи, самостоятельно выбирать ракурс камеры для сбора недостающих данных, интерпретировать увиденное в единой пространственной системе координат и выдавать точные декартовы команды движения, а затем корректировать их по итогам выполнения. Фиксированный контроллер, одинаковый для всех моделей, выполняет только те цели, которые указала сама модель.
Бенчмарк включает 14 базовых семейств задач (11 для одной руки-манипулятора и три для двух рук одновременно), семь дополнительных вариантов с изменённой геометрией и раскладкой объектов для проверки переноса навыков, а также отдельный длинный сценарий с последовательной сборкой из пяти объектов. Авторы проверили 12 моделей в трёх независимых прогонах на одних и тех же 20 физически проверенных сценариях (сидах) на каждую базовую задачу и замерили не только итоговый успех, но и девять поведенческих показателей траектории движения, а также прогресс по подзадачам.
Результаты показывают серьёзный разрыв между отдельными способностями моделей и итоговым успехом. Лучшая модель достигает 100,0% точности в локализации цели и 78,9%, в определении пространственных отношений между объектами в размеченном прогоне, но её итоговый успех по задачам, усреднённый по трём прогонам, всего 53,93±3,17%. Активный выбор ракурса камеры значительно повышает успех по сравнению с пассивным наблюдением с нескольких ракурсов: в одном из сопоставимых сравнений успех вырос с 27,86% до 57,50%. При этом перенос на новую геометрию и раскладку объектов (задачи из семи дополнительных вариантов) может снижать успех более чем на 30 процентных пунктов. Ни одна из моделей не смогла строго завершить длинный сценарий с пятью объектами, хотя частичный прогресс был существенным.
Ключевые факты
- VA-Bench проверяет мультимодальные ИИ-модели на полном цикле «наблюдение, рассуждение, действие, коррекция» без привилегированных данных о положении объектов.
- Бенчмарк включает 14 базовых семейств задач (11 одноручных и три двуручных), семь вариантов с изменённой геометрией и сценарий сборки из пяти объектов.
- Лучшая модель показывает 100,0% в локализации цели и 78,9% в пространственных отношениях, но итоговый успех задач, лишь 53,93±3,17%.
- Активный выбор ракурса камеры поднимает успех с 27,86% до 57,50% по сравнению с пассивным наблюдением.
- Перенос на новую геометрию снижает успех более чем на 30 процентных пунктов, а длинный сценарий с пятью объектами не завершила ни одна модель.
Почему это важно
Большинство существующих тестов пространственного интеллекта дают моделям либо полную информацию о сцене, либо готовые траектории и модули действия, то есть проверяют не реальную способность ориентироваться в пространстве, а способность выполнить уже размеченную задачу. VA-Bench устроен иначе: модель получает только RGB-демонстрации и должна сама решить, откуда посмотреть, что из увиденного значимо и как перевести это в точную команду движения. Это ближе к тому, что реально требуется от робота или агента, действующего в незнакомой среде.
Кому это важно
Разработчикам мультимодальных моделей и исследователям в области робототехники и воплощённого ИИ, тем, кто создаёт агентов, способных не просто отвечать на вопросы о картинке, а действовать в физическом пространстве: манипуляторам, автономным роботам, системам сборки. Результаты бенчмарка дают ориентир, какие способности (выбор ракурса, перенос на новую геометрию, длинные цепочки действий) у текущих моделей слабее всего.
Как это применить
VA-Bench можно использовать как единый набор задач для сравнения моделей: 14 базовых семейств, семь вариантов на перенос навыка и отдельный длинный сценарий с пятью объектами дают возможность проверить не только итоговый успех, но и то, за счёт чего он достигается, девять поведенческих показателей траектории и прогресс по подзадачам. Сравнение «пассивное наблюдение против активного выбора камеры» из бенчмарка показывает, что возможность самой выбирать ракурс, один из немногих факторов, которые заметно поднимают результат (с 27,86% до 57,50% в одном из сравнений), и это практический ориентир при проектировании систем восприятия для воплощённых агентов.
Можно ли доверять
Методология описана подробно: 12 моделей проверены в трёх независимых прогонах на одних и тех же 20 физически проверенных сценариях на каждую базовую задачу, действия моделей выполняет единый для всех фиксированный контроллер, что исключает разницу в исполнении. В самом тексте аннотации не названы ни авторы, ни организация, ни конкретная модель, которая показала лучший результат, это ограничивает проверяемость до появления полного текста работы с указанием авторов и модели-лидера.
Риски и подводные камни
Даже лучшая модель успешно завершает задачи в среднем лишь в половине случаев, а перенос на новую геометрию и раскладку объектов роняет успех более чем на 30 процентных пунктов, это говорит о слабой обобщающей способности текущих моделей за пределами знакомых сценариев. Ни одна модель не смогла строго пройти длинный сценарий с пятью объектами, что указывает на трудности с накоплением ошибок в длинных цепочках действий. Поскольку бенчмарк новый, а автор и релиз кода не названы в самой аннотации, вопрос о воспроизводимости и доступности данных остаётся открытым до публикации деталей.