Учёные выяснили: части речи в SAE кодируются группами латентов, а не отдельными признаками
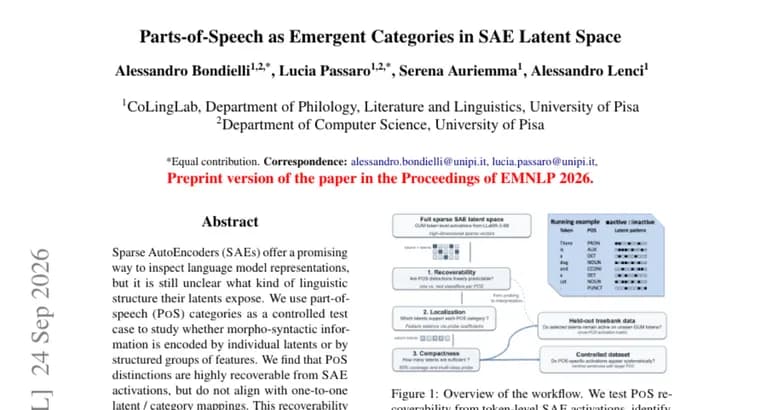
Исследователи изучили, как разреженные автоэнкодеры (Sparse AutoEncoders, SAE), популярный инструмент для интерпретации внутренних представлений языковых моделей, кодируют грамматическую информацию. В качестве контролируемого тестового случая они выбрали части речи (parts-of-speech, PoS): существительные, глаголы, прилагательные, предлоги и другие грамматические категории.
Ключевой вопрос работы: кодируется ли морфо-синтаксическая информация в SAE отдельными латентными признаками, то есть соответствует ли каждой части речи свой «нейрон», или же она распределена по структурированным группам признаков.
Результат: части речи хорошо восстанавливаются по активациям SAE, но не подчиняются принципу «один латент, одна категория». При этом такая восстанавливаемость не сводится к простому запоминанию конкретных слов (лексической памяти). Открытые классы частей речи (существительные, глаголы, прилагательные, категории, пополняемые новыми словами) и закрытые классы (предлоги, союзы и подобные фиксированные списки) заметно различаются по тому, как они представлены в модели.
Каждая категория поддерживается компактной группой разреженных латентов, при этом размер и структура таких групп сильно варьируются между разными частями речи. Группы латентов остаются стабильными на отложенных (held-out) данных, не участвовавших в настройке, но при этом группы для родственных категорий частично пересекаются между собой.
Общий вывод авторов: SAE локализуют морфо-синтаксическую информацию в распределённой, зависящей от конкретной категории форме, а не через атомарные грамматические признаки, то есть отдельного «нейрона глагола» или «нейрона существительного» в чистом виде не существует. В доступном тексте не названы ни авторы, ни организации, ни конкретная языковая модель или архитектура SAE, ни язык данных, ни количественные метрики вроде точности или F1-меры.
Ключевые факты
- SAE не кодируют части речи отдельными «нейронами», каждая часть речи связана с компактной группой из нескольких разреженных латентов.
- Части речи хорошо восстанавливаются по активациям SAE, но это не сводится к простому запоминанию слов моделью.
- Открытые (существительные, глаголы, прилагательные) и закрытые (предлоги, союзы) части речи представлены в SAE существенно по-разному.
- Группы латентов, отвечающие за конкретную часть речи, стабильны на новых данных, но пересекаются с группами родственных категорий.
- Вывод авторов: SAE локализуют грамматическую информацию распределённо и в зависимости от категории, а не через отдельные атомарные признаки.
Почему это важно
Разреженные автоэнкодеры (SAE), один из главных инструментов современной интерпретируемости языковых моделей: с их помощью исследователи пытаются разложить внутренние представления модели на отдельные понятные признаки. Работа показывает, что даже базовая грамматическая структура языка, части речи, не сводится к простым однозначным «нейронам-детекторам», а закодирована распределённо и по-разному для разных категорий. Это важный сигнал для всей области интерпретируемости: ожидание «один признак, одно понятие» не подтверждается даже на таком простом уровне, как грамматика.
Кому это важно
В первую очередь исследователям в области интерпретируемости языковых моделей и разработчикам SAE-инструментов, которые пытаются размечать латентные признаки как отдельные понятные «концепты». Также результат может быть интересен лингвистам, изучающим, как нейросети усваивают грамматическую структуру языка.
Как это применить
Практического инструмента или продукта работа не предлагает, это фундаментальное исследование. Практический вывод для тех, кто анализирует SAE-латенты: не стоит ожидать, что грамматические категории (и, вероятно, другие лингвистические свойства) будут представлены одним чистым признаком, искать и анализировать нужно группы латентов, учитывая, что они могут частично пересекаться между смежными категориями.
Можно ли доверять
Доступный текст, это аннотация научной работы, размещённой на Hugging Face Papers; в нём не указаны ни авторы, ни организация, ни использованная языковая модель или языковой датасет, ни конкретные числовые результаты (точность, F1-мера, количество латентов), что затрудняет независимую проверку выводов без ознакомления с полным текстом статьи.
Риски и подводные камни
Из-за отсутствия количественных данных в доступном тексте сложно оценить, насколько сильны и статистически значимы описанные эффекты. Неясно также, распространяются ли выводы на другие языки, архитектуры SAE и языковые модели помимо использованных в эксперименте, без этих деталей результаты стоит воспринимать как предварительные до знакомства с полной статьёй.
«SAE локализуют морфо-синтаксическую информацию в распределённой и зависящей от категории форме, а не через атомарные грамматические признаки»
— авторы исследования