Учёные предложили RRSI, метод против переобучения самообучающихся ИИ-агентов
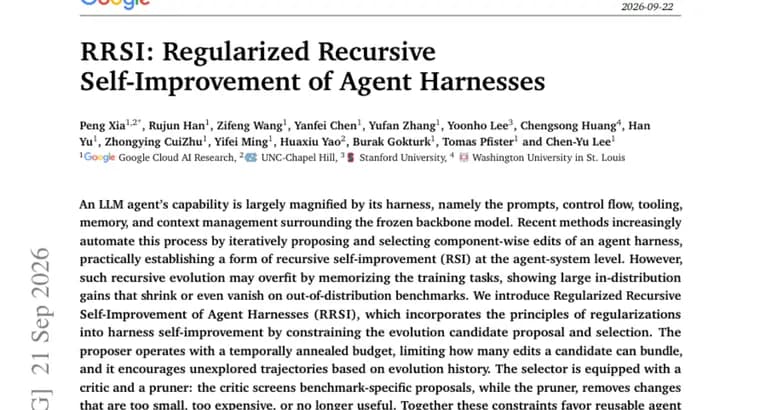
Возможности ИИ-агента во многом определяет не только базовая модель, а харнес вокруг неё, промпты, логика управления, инструменты, память и работа с контекстом. Новые методы всё чаще автоматизируют доработку харнеса: система сама предлагает и отбирает точечные правки его компонентов, по сути рекурсивно самосовершенствуясь (RSI) на уровне всей агентной системы. Проблема в том, что такая рекурсивная эволюция может переобучаться, запоминать конкретные тренировочные задачи: результаты сильно растут на данных, на которых харнес обучали, но этот прирост сжимается или вовсе исчезает на задачах вне обучающего распределения.
Исследователи предложили Regularized Recursive Self-Improvement of Agent Harnesses (RRSI, «регуляризованное рекурсивное самосовершенствование агентных харнесов»), метод, который встраивает принципы регуляризации в процесс самоулучшения, ограничивая и предложение, и отбор кандидатов на правку. Компонент-«предлагатель» работает с бюджетом правок, который постепенно уменьшается со временем (temporally annealed budget) и ограничивает, сколько изменений можно объединить в одном кандидате, а также поощряет неисследованные направления доработки, опираясь на историю уже опробованных эволюций. Компонент-«отборщик» дополнен критиком и «обрезчиком»: критик отсеивает предложения, заточенные под конкретный бенчмарк, а обрезчик убирает изменения, которые слишком малы, слишком дорого обходятся или уже бесполезны. Вместе эти ограничения смещают отбор в сторону переиспользуемых механизмов работы агента, а не решений, подогнанных под конкретный бенчмарк, или случайного шума.
На восьми бенчмарках, задачи из кодинга, агентной работы в рабочем пространстве и инженерного проектирования, RRSI даёт прирост до 14,1 балла на той части данных, на которой харнес непосредственно эволюционировал, и до 4,7 балла на пяти бенчмарках вне обучающего распределения. При этом получившийся харнес расходует на 30% меньше токенов политики (policy tokens), чем харнес, доработанный без регуляризации. Код метода выложен на GitHub в организации google-research, у проекта есть отдельная страница.
Ключевые факты
- RRSI регуляризует рекурсивное самосовершенствование агентных харнесов, чтобы бороться с переобучением под тренировочные бенчмарки
- «Предлагатель» ограничен уменьшающимся со временем бюджетом правок и поощряет неисследованные направления доработки
- «Отборщик» дополнен критиком (отсекает подгонку под бенчмарк) и обрезчиком (убирает мелкие, дорогие или бесполезные правки)
- На восьми бенчмарках прирост до 14,1 балла на тренировочной части и до 4,7 балла на пяти бенчмарках вне распределения
- Получившийся харнес расходует на 30% меньше токенов политики, чем харнес без регуляризации; код открыт на GitHub
Почему это важно
Автоматическое самоулучшение агентных харнесов, растущее направление: вместо того чтобы инженеры вручную правили промпты и логику агента, систему заставляют предлагать и отбирать такие правки саму. Но именно такая рекурсивная эволюция рискует запомнить особенности тренировочных задач вместо того, чтобы находить общеполезные улучшения, и тогда впечатляющий прирост на бенчмарке, на котором харнес обучали, не переносится на реальные, чуть иначе устроенные задачи. RRSI показывает, что этот разрыв можно сократить встроенными в процесс отбора ограничениями, а не только увеличением числа итераций эволюции.
Кому это важно
Работа адресована тем, кто разрабатывает или исследует автоматизированное улучшение ИИ-агентов и их харнесов: инженерам агентных систем, исследователям RSI-методов и командам, которые оценивают агентов не на одном бенчмарке, а на разнородном наборе задач, кодинге, работе с инструментами рабочего пространства, инженерном проектировании.
Как это применить
RRSI встраивается в существующий цикл предложения и отбора правок харнеса как дополнительный слой ограничений: бюджет правок на кандидата, поощрение неисследованных направлений, критик против подгонки под конкретный бенчмарк и обрезчик, отсеивающий малополезные изменения. Код и данные для воспроизведения выложены в открытом доступе на GitHub (организация google-research), у метода есть отдельная проектная страница.
Можно ли доверять
Метод проверен на восьми бенчмарках из трёх разных областей (кодинг, агентная работа в рабочем пространстве, инженерное проектирование), причём отдельно измерен результат на тренировочной части и на пяти бенчмарках вне обучающего распределения, это прямая проверка заявленной цели (снижение переобучения), а не только рост общего балла. Код открыт, что позволяет проверить результаты независимо. В самом источнике не названы ни авторы работы, ни их институциональная принадлежность, ни конкретные методы-конкуренты, с которыми сравнивался RRSI (сравнение дано только с «нерегуляризованной эволюцией» как таковой), это ограничивает возможность оценить работу в контексте, отдельного от неё самой.
Риски и подводные камни
Источник не называет, какие именно правки предыдущих методов RRSI заменяет, и не раскрывает состав всех восьми бенчмарков, судить о переносимости результата на задачи за пределами протестированного набора напрямую нельзя. Дополнительные компоненты (критик, обрезчик, отслеживание истории эволюции) усложняют и, вероятно, удорожают сам процесс самоулучшения по сравнению с нерегуляризованной версией, источник не приводит цифр по стоимости или времени эволюции, только по итоговому расходу токенов готового харнеса. Наконец, прирост в 4,7 балла вне распределения показывает, что переобучение смягчено, но не устранено полностью.