Учёные объяснили, почему видео от ИИ нарушает физику: виноват RoPE
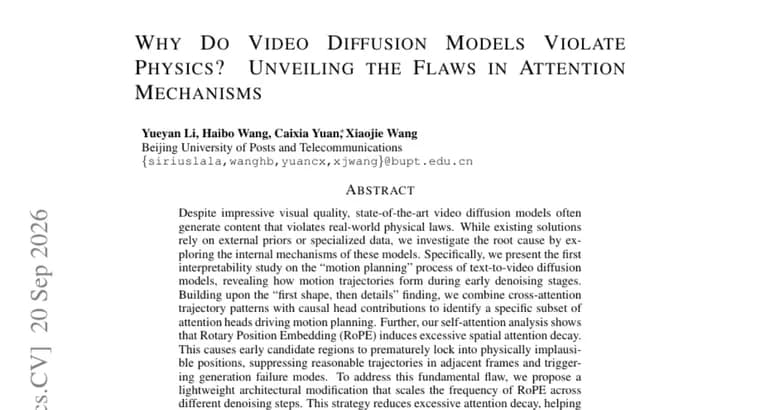
Группа исследователей провела первое интерпретируемое исследование того, как современные диффузионные модели генерации видео по тексту планируют движение объектов на кадрах, и объяснила, почему видео от таких моделей систематически нарушает законы физики. В отличие от более ранних работ, которые опирались на внешние физические приоритеты или специализированные данные, авторы изучили внутренний механизм самих моделей.
Оказалось, что модель сначала формирует общую форму сцены и лишь потом прорабатывает детали (принцип «сначала форма, потом детали»). Сопоставив паттерны траекторий в кросс-внимании (cross-attention) с вкладом отдельных «причинных» голов внимания, авторы выделили конкретную группу голов внимания, которая отвечает за планирование движения.
Дальнейший анализ self-attention вскрыл корень проблемы: позиционное кодирование RoPE (Rotary Position Embedding) вызывает чрезмерное затухание пространственного внимания. Из-за этого кандидатные области на ранних шагах денойзинга слишком рано «залипают» в физически неправдоподобных положениях, подавляя правдоподобные траектории в соседних кадрах, это и приводит к сбоям генерации, то есть к нарушениям физики в готовом видео.
Чтобы устранить проблему, авторы предложили лёгкую архитектурную правку: масштабировать частоту RoPE на разных шагах денойзинга. Это снижает избыточное затухание внимания и помогает модели находить более удачные кандидатные области, благодаря чему движение в видео становится более физически связным. Эффективность подхода проверена и в режиме без дообучения (training-free), и с дообучением (training-based), оба варианта эксперимента подтвердили улучшение физической правдоподобности генерируемых видео.
В самой аннотации работы нет числовых результатов, сравнения с базовыми моделями, названия конкретной видеомодели, на которой проверялся метод, имён авторов и организаций, а также даты публикации.
Ключевые факты
- Впервые изучен внутренний механизм «планирования движения» в диффузионных моделях генерации видео по тексту.
- Модель сначала формирует общую форму сцены и лишь потом детали; за планирование движения отвечает конкретная группа голов внимания.
- Причина нарушений физики, избыточное затухание пространственного внимания из-за позиционного кодирования RoPE.
- Предложена лёгкая архитектурная правка: масштабирование частоты RoPE по шагам денойзинга.
- Метод проверен в training-free и training-based экспериментах и улучшает физическую правдоподобность видео.
Почему это важно
Видео от диффузионных моделей выглядит убедительно, но объекты в нём проходят сквозь препятствия, меняют форму или движутся неестественно, и до сих пор это лечили заплатками снаружи: добавляли внешние физические приоритеты или специальные обучающие данные. Эта работа впервые открывает «чёрный ящик» и показывает, что проблема рождается внутри самого механизма внимания на ранних шагах денойзинга, а не является следствием нехватки данных о физике.
Кому это важно
В первую очередь, исследователям и инженерам, которые строят и дообучают диффузионные модели генерации видео по тексту: работа даёт им конкретный, локализуемый источник ошибки (конкретную группу голов внимания и конкретный механизм, RoPE) вместо расплывчатого «модель не понимает физику».
Как это применить
Предложенная правка, масштабирование частоты RoPE на разных шагах денойзинга, описана как лёгкая архитектурная модификация, а не полная переобучение модели с нуля. Авторы проверили её как в training-free варианте (без дообучения), так и в training-based варианте (с дообучением), и оба варианта дали улучшение физической правдоподобности видео. Название конкретной модели, к которой применили метод, в источнике не указано.
Можно ли доверять
Работа, это research paper, размещённый на Hugging Face Papers, то есть научная публикация, а не маркетинговый анонс продукта. При этом в доступной аннотации нет численных результатов, сравнения с базовыми моделями и указания, на какой именно видеомодели проверялся метод, судить о масштабе улучшения по одному описанию нельзя.
Риски и подводные камни
Аннотация не называет ни авторов, ни организацию, ни дату публикации, ни доступность кода или данных, поэтому независимо проверить и воспроизвести результат по одному этому источнику нельзя. Неясно и то, насколько находка про RoPE переносится на видео-диффузионные модели с другими схемами позиционного кодирования, в тексте это не оговаривается.