Три LLM, писавшие веса вручную, выбрали таблицу вместо Transformer
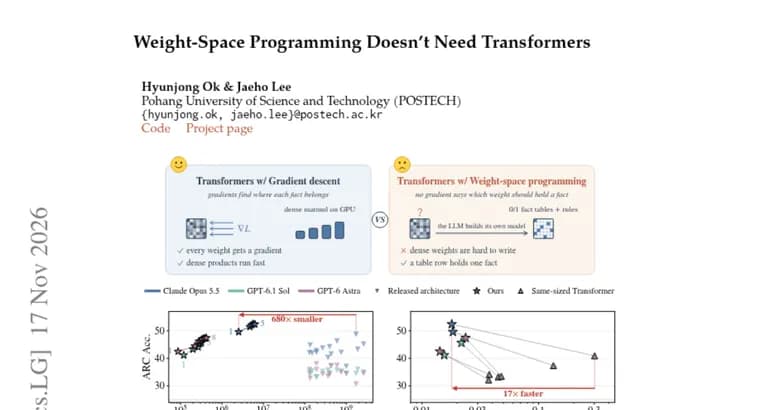
Авторы препринта рассматривают «программирование в пространстве весов» (weight-space programming): большая языковая модель (LLM) сама вручную записывает целевые веса другой модели, без градиентного обучения. Стандартные архитектуры вроде Transformer выбирали потому, что они хорошо обучаются градиентным спуском и быстро работают на GPU. Когда веса пишутся вручную, эти доводы, по мнению авторов, перестают действовать, и возникает вопрос: стоит ли сохранять Transformer?
Эксперимент устроен так. Трём передовым LLM дали минимальные инструкции, десять размеченных примеров и песочницу; задачи в основном были в формате вопросов с выбором ответа. Модели должны были либо сгенерировать веса для заданной архитектуры, либо сами спроектировать архитектуру. Когда выбор был свободным, все три модели превращали факты из обычного текста в разреженную таблицу, к которой обращаются по фиксированной процедуре. Такие модели достигали точности на тесте до 54,4%.
По утверждению авторов, модель, спроектированная LLM, показала более высокую точность на тесте, чем самый точный из выпущенных Transformer, который написала та же LLM, и при этом использовала примерно в 1800 раз меньше параметров.
Почему выбрана таблица: без градиентов LLM предпочитает структуру, где она может объяснить смысл каждого веса, найти неверный и переписать его. Каждый неправильный ответ указывает на одну строку, а удаление строки меняет примерно один другой ответ. Исходя из этого авторы предлагают модель на основе ассоциативной памяти, которая на GPU работает до 17 раз быстрее Transformer того же размера.
Дополнительно авторы проверяют предобученные веса, другие тесты и задачи, где модели генерируют ответы. Они подчёркивают: предобученные LLM остаются точнее, а их утверждение касается лишь того, какую структуру строить, когда веса пишутся вручную.
Ключевые факты
- Три передовые LLM получили минимальные инструкции, десять размеченных примеров и песочницу; задачи в основном были с выбором ответа.
- При свободном выборе архитектуры все три модели составили из текстовых фактов разреженную таблицу с фиксированной процедурой обращения; точность на тесте достигала 54,4%.
- Спроектированная LLM модель превзошла по точности самый точный выпущенный Transformer, написанный той же LLM, при примерно в 1800 раз меньшем числе параметров.
- Предложенная авторами модель на основе ассоциативной памяти на GPU до 17 раз быстрее Transformer того же размера.
- Предобученные LLM остаются точнее: авторы говорят о выборе структуры при ручной записи весов, а не о превосходстве над обычными LLM.
Почему это важно
Работа ставит под вопрос привычное допущение: Transformer выбирают из-за удобства градиентного обучения и скорости на GPU. Если веса пишет LLM, а не градиентный спуск, эти доводы, как утверждают авторы, не работают. Тогда на первый план выходит другое свойство: можно ли понять, что означает каждый вес, и исправить ошибку точечно. В таблице каждый неправильный ответ указывает на одну строку, а удаление строки меняет примерно один другой ответ. Это делает такую структуру более прозрачной для исправления, чем Transformer.
Кому это важно
Прежде всего исследователям архитектур и интерпретируемости, а также тем, кто изучает способность LLM создавать другие модели без обучения. Для широкого круга практиков работа пока скорее концептуальная: речь о малой точности (до 54,4%) и об идее, а не о готовом продукте.
Как это применить
Прямого практического рецепта в аннотации нет. Идея для экспериментов: вместо обучения модели просить LLM записывать знания в явную таблицу или структуру в стиле ассоциативной памяти, где каждый вес можно прочитать и поправить вручную. В аннотации не сказано, опубликованы ли код или веса, поэтому воспроизводить результаты придётся по полному тексту работы.
Можно ли доверять
Это препринт, и все выводы опираются на заявления авторов в аннотации. Названия трёх LLM, тесты и наборы данных, а также точность сравниваемого Transformer в ней не указаны. Цифра 54,4%, максимум («до»), а не среднее. Сравнение в 1800 раз по числу параметров относится к самому точному выпущенному Transformer, написанному той же LLM, а не к предобученным промышленным моделям. Скорость «до 17 раз» тоже максимум, детали оборудования и настройки не приведены. Сами авторы прямо оговаривают, что предобученные LLM остаются точнее.
Риски и подводные камни
Главный риск, прочитать результат шире, чем он заявлен: работа не утверждает, что таблицы лучше Transformer вообще. Тесты в основном с выбором ответа и десятью примерами, поэтому перенос на открытую генерацию текста неочевиден: авторы лишь заявляют, что проверяют и такие задачи, но результатов в аннотации нет. Высокие числа по параметрам и скорости, верхние оценки, привязанные к конкретным условиям сравнения.
«Предобученные LLM остаются более точными; утверждение касается того, какую структуру строить при записи весов.»
— авторы препринта, аннотация