Test-Time Baking ускоряет синтез новых ракурсов сцены до 23 раз
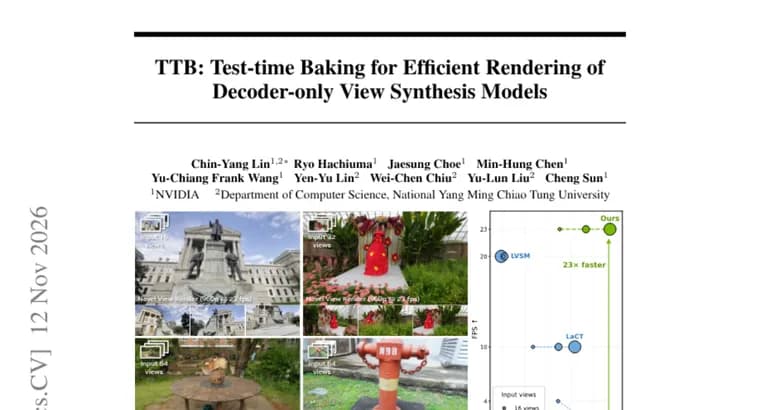
Декодерные Large View Synthesis Models (LVSM, большие модели синтеза ракурсов) с KV-кэшем недавно достигли лучшего качества: они предсказывают новые ракурсы сцены напрямую нейросетью, не восстанавливая 3D-геометрию. Слабое место, скорость отрисовки. Слои Test-Time Training (TTT, обучение во время работы модели) экономят вычисления, но, по словам авторов, жертвуют качеством.
Авторы предлагают стратегию Test-Time Baking (TTB). Она учится «запекать» глобальную информацию о сцене, которую модель получает через перекрёстное внимание между ракурсами (cross-view attention), в лёгкую MLP (небольшую полносвязную сеть). Благодаря этому новые ракурсы декодируются быстро и с высокой точностью.
Первая ключевая идея: быстрые веса (fast-weight MLP) из TTT используют не для полной замены внимания, а чтобы явно выучить отображение, которое реализует перекрёстное внимание, по парам «вход, выход». Авторы утверждают, что так достигается та же эффективность отрисовки, что у TTT, но с существенно более высоким качеством.
Вторая идея решает несоответствие модальностей между предзаполнением контекста и отрисовкой нового ракурса. Контекстные токены разделяют на две группы: токены контекста только с камерой (вход для TTB) и токены контекста с эталонным содержимым изображения (целевое отображение для TTB). Так «запечённым» MLP не приходится справляться с обобщением между обработкой контекста и новых ракурсов.
Итог по заявлению авторов: ускорение отрисовки до 23 раз при качестве на уровне лучших существующих методов на нескольких бенчмарках. Качество, таким образом, не превосходит прежний уровень, а сохраняется. Есть страница проекта: https://test-time-baking.github.io
Ключевые факты
- Метод Test-Time Baking (TTB) «запекает» глобальную информацию о сцене из перекрёстного внимания между ракурсами в лёгкую MLP.
- Заявлено ускорение отрисовки до 23 раз при качестве на уровне лучших методов на нескольких бенчмарках.
- Первая идея: быстрые веса TTT используют, чтобы явно выучить отображение внимания, а не заменять внимание целиком.
- Вторая идея: контекстные токены делят на токены только с камерой (вход) и токены с содержимым изображения (цель), чтобы убрать несоответствие модальностей.
Почему это важно
Декодерные модели синтеза ракурсов дают лучшее качество без восстановления 3D-геометрии, но медленны на этапе отрисовки. Альтернатива на слоях TTT быстрее, но теряет в качестве. TTB заявляет компромисс: скорость уровня TTT при качестве на уровне лучших методов.
Кому это важно
Исследователям нейронного рендеринга и синтеза новых ракурсов, а также тем, кто занимается эффективным внимание-подобным выводом и слоями TTT.
Как это применить
Из описания видно лишь идею метода и страницу проекта (https://test-time-baking.github.io). Сведений о коде, весах, оборудовании и условиях использования в тексте нет, поэтому практическое применение пока оценить нельзя.
Можно ли доверять
Это аннотация научной работы: все утверждения принадлежат самим авторам. Цифра 23 раза, максимум («до»), база для сравнения в тексте не указана. Названия бенчмарков, метрики и их значения в описании не приведены, поэтому проверить заявление по тексту нельзя.
Риски и подводные камни
Качество «на уровне» лучших методов, это паритет, а не превосходство. Ускорение до 23 раз, пиковое значение, типичное может быть заметно ниже. Без данных о железе, размерах моделей и абсолютном времени отрисовки реальный выигрыш в других условиях оценить трудно.