T1 решает 64,0% задач Terminal-Bench 2.1 и обходит GPT-5.4 и GLM-5.1
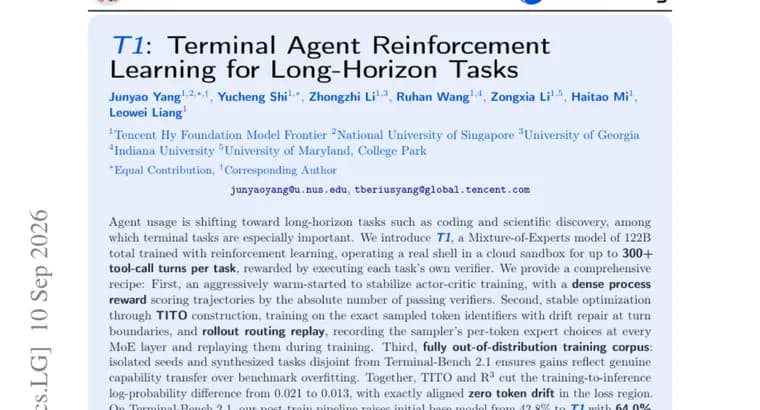
Использование ИИ-агентов смещается от коротких запросов к длинным, многошаговым задачам, таким как программирование и научные исследования, и среди них особенно важны задачи, где агент работает прямо в командной строке (терминале). Авторы представляют T1, модель типа Mixture-of-Experts (MoE, «смесь экспертов») с суммарным числом параметров 122 миллиарда, дообученную обучением с подкреплением (RL) так, чтобы она управляла настоящим шеллом в облачной песочнице: на одну задачу ей разрешено до 300 с лишним обращений к инструментам (tool-call turns), а награду она получает за прохождение собственного верификатора каждой задачи.
Рецепт обучения состоит из трёх частей. Во-первых, обучение по схеме «актор-критик» стабилизировано агрессивным тёплым стартом и плотной наградой на уровне процесса: траектории модели оцениваются по абсолютному числу пройденных верификаторов, а не только по итоговому успеху. Во-вторых, устойчивость оптимизации даёт связка из двух приёмов: TITO, обучение на точных идентификаторах токенов, которые модель сама выбрала при генерации, с исправлением расхождений на границах шагов, и воспроизведение маршрутизации экспертов MoE между генерацией ответов (rollout) и обучением: система запоминает, каких экспертов сэмплер выбрал для каждого токена, и повторяет те же решения при обучении. По итогам авторы указывают, что вместе TITO и приём, который они обозначают как R3, сократили разрыв между обучением и инференсом по логарифмической вероятности (log-probability) с 0,021 до 0,013, добившись нулевого дрифта токенов в зоне, значимой для функции потерь. В-третьих, обучающий корпус сделан полностью независимым от тестовых данных: изолированные затравки и синтезированные задачи не пересекаются с Terminal-Bench 2.1, по словам авторов, это гарантирует, что прирост результата отражает реальный перенос навыка, а не подгонку модели под конкретный тест.
Результат: на Terminal-Bench 2.1 весь пайплайн дообучения поднимает долю решённых задач с 43,8% у исходной базовой модели до 64,0% у T1. На отдельном тесте для более длинных горизонтов, Long-Horizon Terminal Bench, T1 набирает 27,9% и, по данным авторов, превосходит на нём GPT-5.4 и GLM-5.1, конкретный разрыв в баллах с этими моделями в тексте не приведён.
Ключевые факты
- T1, MoE-модель с суммарно 122 млрд параметров; управляет настоящим шеллом в облачной песочнице и получает до 300 с лишним обращений к инструментам (tool-call turns) на одну задачу.
- Обучение, трёхчастный RL-рецепт: тёплый старт актор-критика с плотной наградой по числу пройденных верификаторов; приём TITO (точные идентификаторы токенов с исправлением дрифта на границах шагов) и воспроизведение маршрутизации экспертов между генерацией и обучением; обучающий корпус, изолированный от Terminal-Bench 2.1.
- Вместе TITO и приём, обозначенный авторами как R3, сократили разрыв между обучением и инференсом по log-probability с 0,021 до 0,013, с нулевым дрифтом токенов в зоне, значимой для функции потерь.
- На Terminal-Bench 2.1 T1 решает 64,0% задач, против 43,8% у исходной базовой модели до RL-дообучения.
- На Long-Horizon Terminal Bench T1 набирает 27,9% и, по словам авторов, превосходит GPT-5.4 и GLM-5.1, конкретный разрыв в баллах не указан.
Почему это важно
Авторы описывают общий сдвиг: использование ИИ-агентов смещается от коротких запросов к длинным, многошаговым задачам, программированию, научным исследованиям, и среди них особенно значимы задачи, где агент работает прямо в терминале. T1 показывает, что RL-дообучение для такого агента можно сделать заметно устойчивее: разрыв между обучением и инференсом по log-probability у T1 сокращён, с 0,021 до 0,013, с нулевым дрифтом токенов в зоне, значимой для функции потерь. Отдельно авторы закладывают защиту от переобучения под тест: обучающие задачи умышленно не пересекаются с Terminal-Bench 2.1, чтобы прирост результата (с 43,8% до 64,0%) нельзя было списать на подгонку модели под конкретный набор проверочных задач.
Кому это важно
Прежде всего, командам, которые обучают или дообучают LLM-агентов для работы с кодом, DevOps и другими сценариями, где модель управляет реальной командной строкой: T1 даёт конкретный рецепт, тёплый старт, награда по верификаторам, TITO, воспроизведение маршрутизации экспертов, строго изолированный от теста обучающий корпус. Во-вторых, тем, кто ориентируется на Terminal-Bench 2.1 и Long-Horizon Terminal Bench как эталон для агентных моделей: по данным авторов, T1 обходит на длинных горизонтах GPT-5.4 и GLM-5.1. В-третьих, исследователям MoE-архитектур: рецепт напрямую решает характерную для MoE проблему, расхождение маршрутизации экспертов между генерацией и обучением.
Как это применить
Практическая ценность материала, в наборе техник, которые можно перенести в собственный RL-пайплайн для агента: агрессивный тёплый старт перед обучением актор-критика; плотная награда, считающая пройденные верификаторы, а не только финальный успех; исправление дрифта токенов на границах шагов (TITO); повтор маршрутизации экспертов MoE между генерацией и обучением; и жёсткое разделение обучающих и тестовых задач, чтобы сам способ измерения прироста не вызывал вопросов.
Можно ли доверять
Это самостоятельная публикация в духе препринта (страница на Hugging Face Papers), без стороннего аудита результатов; текст не называет ни одного автора и не указывает организацию, что не позволяет оценить репутацию и опыт авторского коллектива. В плюс работе, то, что авторы сами закладывают защиту от переобучения под тест (обучающий корпус, изолированный от Terminal-Bench 2.1) и приводят техническую метрику устойчивости обучения (разрыв по log-probability 0,021 → 0,013), а не только итоговый процент. В минус, сравнение с GPT-5.4 и GLM-5.1 дано без разрыва в баллах (только слово «превосходит»), а объём обучающих данных, вычислительных ресурсов и число шагов обучения в тексте не раскрыты, проверить рецепт независимо по одной статье не получится.
Риски и подводные камни
Методологический риск остаётся даже при строгом разделении данных: синтезированные обучающие задачи и тестовые бенчмарки всё равно ближе друг к другу по конструкции, чем к непредсказуемому реальному шеллу в проде, высокий балл на двух конкретных тестах не равен надёжности за их пределами. Отсутствие цифр по разрыву с GPT-5.4 и GLM-5.1 не даёт понять, насколько устойчиво преимущество T1, «превосходит» может означать и доли процента, и заметный отрыв. Наконец, агент с бюджетом 300 с лишним обращений к инструментам в реальном шелле по своей природе получает широкие практические полномочия, это стандартный повод для вопроса о контроле над таким агентом, независимо от того, что написано в самой статье.