StochBench: агент на Opus 4.8 доказал 34,9% из 450 задач по теории вероятностей
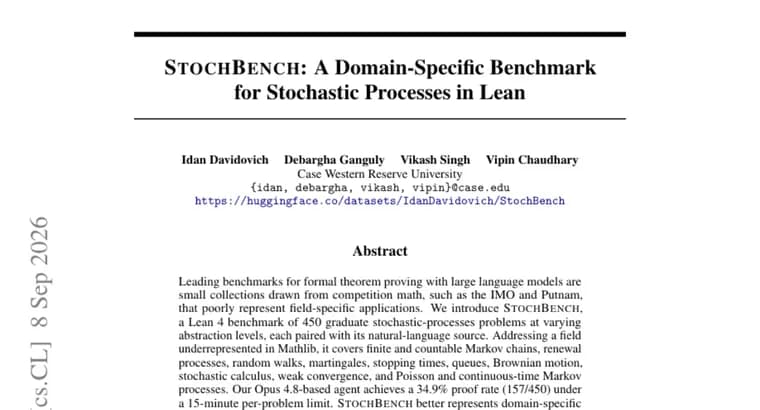
Существующие бенчмарки для формальных доказательств теорем с помощью больших языковых моделей, это небольшие подборки задач из соревновательной математики вроде IMO и Putnam, которые плохо отражают применение в конкретных предметных областях. Чтобы закрыть этот пробел, исследователи представили StochBench, бенчмарк на языке формальной верификации Lean 4, состоящий из 450 задач уровня выпускника вуза по теории вероятностей и случайным процессам разного уровня абстракции. Каждая задача снабжена формулировкой на естественном языке.
StochBench охватывает раздел математики, слабо представленный в библиотеке Mathlib для Lean: конечные и счётные марковские цепи, процессы восстановления, случайные блуждания, мартингалы, моменты остановки, теорию очередей, броуновское движение, стохастическое исчисление, слабую сходимость, а также пуассоновские и непрерывные марковские процессы.
Авторы протестировали на бенчмарке агента на основе модели Opus 4.8: при лимите в 15 минут на задачу он доказал 157 из 450 задач, то есть 34,9%. По утверждению авторов, StochBench лучше отражает прикладную предметно-специфичную математику, оставаясь при этом сложным тестом даже для продвинутых систем автоматического доказательства теорем.
Ключевые факты
- StochBench, новый бенчмарк на Lean 4 из 450 задач уровня выпускника вуза по теории вероятностей и случайным процессам, каждая с формулировкой на естественном языке
- Тематика охватывает марковские цепи, процессы восстановления, случайные блуждания, мартингалы, моменты остановки, очереди, броуновское движение, стохастическое исчисление, слабую сходимость и пуассоновские процессы
- Агент на основе Opus 4.8 доказал 157 из 450 задач (34,9%) при лимите 15 минут на задачу
- Авторы указывают, что существующие бенчмарки (IMO, Putnam), небольшие подборки соревновательной математики, плохо отражающие прикладные предметные области
- Раздел стохастических процессов, по словам авторов, слабо представлен в библиотеке Mathlib для Lean, StochBench закрывает этот пробел
Почему это важно
Большинство бенчмарков для проверки способности ИИ доказывать теоремы построено на соревновательной математике, задачах уровня IMO и Putnam. Такие задачи компактны и эффектны, но плохо показывают, справится ли модель с математикой, которая реально используется в прикладных областях. StochBench, попытка закрыть этот разрыв на примере теории вероятностей и случайных процессов: раздела, который активно применяется в статистике, финансах, физике и инженерии, но слабо представлен в существующих формальных библиотеках вроде Mathlib.
Кому это важно
В первую очередь, исследователям, которые занимаются формальной верификацией и автоматическим доказательством теорем с помощью языковых моделей, а также сообществу Lean и Mathlib, куда раздел стохастики пока добавлен неполно. Полезен бенчмарк и лабораториям, которые оценивают математические способности своих моделей: в статье в качестве тестируемого агента использована модель Opus 4.8.
Как это применить
StochBench можно использовать как стандартизованный тест для сравнения ИИ-агентов, доказывающих теоремы в Lean 4: единый набор из 450 задач и одинаковый лимит в 15 минут на задачу дают сопоставимую метрику. Разработчики агентов для формального доказательства теорем могут прогнать через него собственные модели и сравнить результат с показателем 34,9%, полученным на Opus 4.8.
Можно ли доверять
Материал, научная статья с конкретными, точно указанными цифрами: 450 задач, 157 решённых, 34,9% доля успеха, лимит 15 минут на задачу. В доступном тексте не указаны ни авторы и их принадлежность к организации, ни дата публикации, ни сравнение с результатами других бенчмарков или моделей, ни показатель человека-эксперта для сопоставления с 34,9%.
Риски и подводные камни
Результат в 34,9% получен для одного конкретного агента на основе Opus 4.8, без данных о том, как с этим же бенчмарком справляются другие модели или люди-эксперты, судить о том, насколько это хороший или плохой показатель, сложно. Текст также не раскрывает, какие именно типы задач (например, мартингалы против броуновского движения) агенту дались легче или тяжелее, это ограничивает возможность сделать выводы о конкретных сильных и слабых сторонах модели.