StepX-OPD объединяет два этапа обучения диффузионных нейросетей в один
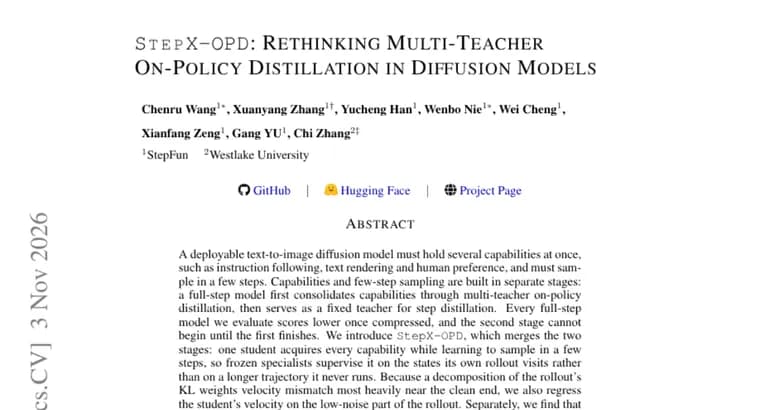
Авторы препринта исходят из того, что пригодная к практике диффузионная модель генерации изображений по тексту должна одновременно уметь несколько вещей, например следовать инструкциям, рисовать текст на картинке и соответствовать человеческим предпочтениям, а ещё сэмплировать за малое число шагов. Сейчас навыки и быстрый сэмплинг формируют в разных стадиях: сначала полношаговая модель собирает навыки через дистилляцию с несколькими учителями на собственных траекториях (multi-teacher on-policy distillation), а затем служит фиксированным учителем для дистилляции по шагам (step distillation).
У такой схемы два недостатка, на которые указывают авторы: каждая оценённая ими полношаговая модель показывает более низкий результат после сжатия, а вторая стадия не может начаться, пока не закончится первая.
StepX-OPD объединяет две стадии. Один ученик осваивает все навыки и одновременно учится сэмплировать за несколько шагов. Замороженные специалисты-учителя контролируют его на тех состояниях, которые проходит его собственная траектория, а не на более длинной траектории, которую он сам никогда не выполняет. Кроме того, поскольку разложение KL-расхождения траектории сильнее всего взвешивает рассогласование скорости ближе к «чистому» концу (малому шуму), авторы дополнительно обучают скорость ученика регрессией на малошумной части траектории.
Отдельное наблюдение: при объединении навыков модели начинают вписывать слова из запроса в изображение, даже когда запрос текста не предполагал. Авторы предлагают вариант метода, который это снижает (не устраняет).
Оценка проведена на SD3.5-Medium и FLUX.1-dev по четырём направлениям: следование инструкциям, отрисовка текста, качество изображений и человеческие предпочтения. На обеих архитектурах StepX-OPD, по утверждению авторов, получает наивысший нормированный средний балл среди сравниваемых четырёхшаговых методов и превосходит сорокашаговую модель Flow-OPD. На SD3.5-Medium обучение требует примерно на 37% меньше GPU-часов, чем последовательность DiffusionOPD и затем дистилляции по шагам.
Ключевые факты
- StepX-OPD сливает в один этап сборку навыков (дистилляцию с несколькими учителями) и дистилляцию по шагам для диффузионных моделей генерации изображений.
- Замороженные специалисты контролируют ученика на состояниях его собственной траектории; скорость ученика дополнительно обучается на малошумной части траектории.
- Оценка на SD3.5-Medium и FLUX.1-dev: наивысший нормированный средний балл среди сравниваемых четырёхшаговых методов и результат выше сорокашаговой модели Flow-OPD.
- На SD3.5-Medium обучение примерно на 37% дешевле по GPU-часам, чем DiffusionOPD с последующей дистилляцией по шагам.
- Найден побочный эффект объединения навыков: модели вписывают слова запроса в картинку без просьбы о тексте; предложен вариант, снижающий этот эффект.
Почему это важно
Чтобы нейросеть для генерации изображений была пригодна к использованию, она должна и уметь много, и работать быстро, за несколько шагов. По описанию авторов, нынешний путь двухстадийный: сначала сборка навыков, затем сжатие по шагам, причём после сжатия оценённые ими модели теряют в качестве, а вторая стадия ждёт первую. StepX-OPD пытается убрать эту последовательность и обучать всё сразу.
Кому это важно
Прежде всего исследователям и командам, которые дообучают и ускоряют диффузионные модели вроде SD3.5-Medium и FLUX.1-dev и считают GPU-часы. Для обычных пользователей генераторов изображений это пока методика обучения, а не готовый продукт.
Как это применить
В описании работы не упоминается ни код, ни выпуск моделей, ни доступность данных, поэтому воспроизвести метод по одному аннотированному тексту нельзя. Практический ориентир, который называют авторы: на SD3.5-Medium экономия составляет примерно 37% GPU-часов относительно последовательного пайплайна DiffusionOPD плюс дистилляция по шагам.
Можно ли доверять
Все результаты, утверждения самих авторов из аннотации препринта. Названия авторов и организаций в тексте не указаны. Конкретных значений метрик и названий бенчмарков нет: сказано лишь про «наивысший нормированный средний балл» среди четырёхшаговых методов. Экономия в 37% заявлена только для SD3.5-Medium, для FLUX.1-dev цифры нет. Это препринт, независимая проверка не упомянута.
Риски и подводные камни
Превосходство над сорокашаговой Flow-OPD и над другими четырёхшаговыми методами подтверждено лишь заявлением в аннотации, без абсолютных чисел. Сам метод, по словам авторов, порождает побочный эффект: модели вписывают слова запроса в изображение, когда текст не просили. Предложенный вариант лишь снижает проблему, количественной оценки снижения в тексте нет.