Статья про late entry: Ouro-2.6B и Huginn-3.5B декодируют до 8,4 раза быстрее
Зацикленные языковые модели (looped language models) углубляют рассуждение при небольшом числе параметров: один и тот же стек слоёв прогоняется T раз на каждый токен. Обратная сторона, глубина рекурсии напрямую превращается в последовательную задержку при генерации.
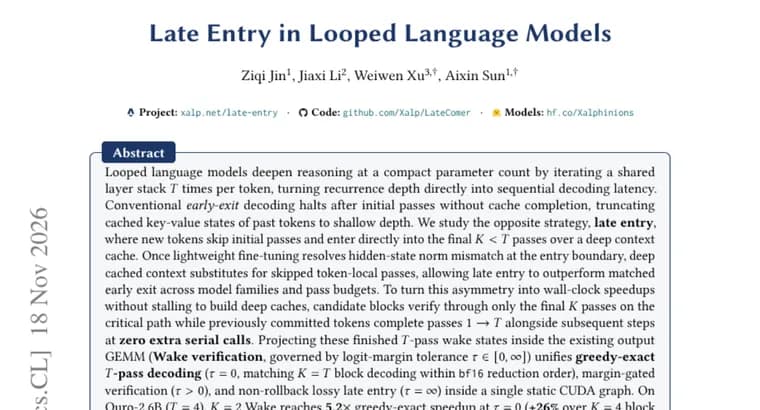
Обычный ранний выход (early exit) останавливает вычисление после первых проходов и не достраивает кэш, поэтому кэшированные key-value-состояния прошлых токенов остаются «обрезанными» до малой глубины. В статье изучают противоположную стратегию, late entry (поздний вход): новые токены пропускают начальные проходы и входят сразу в последние K < T проходов, опираясь на глубокий кэш контекста. По описанию в аннотации, после лёгкого дообучения, которое устраняет рассогласование норм скрытых состояний на границе входа, глубокий кэшированный контекст заменяет пропущенные токен-локальные проходы. Из-за этого поздний вход превосходит ранний выход при сопоставимом бюджете проходов у разных семейств моделей.
Чтобы превратить это в реальное ускорение по времени, а не только по числу проходов, предложена схема Wake verification. Блоки токенов-кандидатов проверяются только через последние K проходов на критическом пути, а уже подтверждённые токены дорабатывают проходы с 1-го по T-й параллельно со следующими шагами, без дополнительных последовательных вызовов. Готовые T-проходные «wake»-состояния проецируются внутри существующего выходного GEMM (матричного умножения). Схема управляется допуском по разности логитов tau из диапазона от 0 до бесконечности и объединяет три режима в одном статическом CUDA-графе: tau = 0, точное жадное T-проходное декодирование (совпадает с блочным декодированием K = T с точностью до порядка редукции в bf16); tau > 0, верификация с отсечкой по запасу логитов; tau = inf, «с потерями», без откатов.
Результаты. На Ouro-2.6B (T = 4) вариант K = 2 Wake даёт 5,2 раза ускорения в точном жадном режиме (tau = 0), что на 26% выше блочного декодирования с K = 4 на GSM8K. При tau = inf ускорение составляет 6,8 раза, и результат на 16,9 пункта лучше обученного раннего выхода при той же скорости (какая именно метрика, в этой фразе аннотации не названо). На Huginn-3.5B проверили масштабирование рекурсии на этапе вывода при T из {8, 16, 32, 64}: число откатов при K = T/4 с ростом глубины сокращается в 21,5 раза. Точное ускорение достигает 6,1 раза при T = 32 и 8,4 раза при T = 64 (+153% к блочному декодированию с K = 64), а при tau = inf, от 10,6 до 12,5 раза.
Ключевые факты
- Late entry: новые токены пропускают первые проходы и входят сразу в последние K < T проходов поверх глубокого кэша контекста, в отличие от раннего выхода, который обрезает кэш до малой глубины.
- Для рабочего ускорения предложена Wake verification: кандидаты проверяются только через последние K проходов, а подтверждённые токены дорабатывают проходы 1 → T параллельно, всё в одном статическом CUDA-графе.
- Ouro-2.6B (T = 4): K = 2 Wake даёт 5,2 раза в точном режиме (tau = 0) и 6,8 раза при tau = inf, где результат на 16,9 пункта выше обученного раннего выхода при той же скорости.
- Huginn-3.5B: откаты при K = T/4 реже в 21,5 раза с ростом глубины; точное ускорение 6,1 раза (T = 32) и 8,4 раза (T = 64), при tau = inf, 10,6-12,5 раза.
- Для работы нужно лёгкое дообучение, которое устраняет рассогласование норм скрытых состояний на границе входа.
Почему это важно
У зацикленных моделей качество растёт за счёт повторных проходов по одним и тем же слоям, но каждый проход прибавляет задержку при генерации. Работа атакует именно эту цену рекурсии: вместо того чтобы обрезать вычисление (ранний выход), она пропускает начало и опирается на уже накопленный глубокий кэш. Заявленные ускорения, от 5,2 до 8,4 раза в точном жадном режиме, были бы существенными, если подтвердятся независимыми замерами.
Кому это важно
Исследователям зацикленных и рекуррентных по глубине моделей и тем, кто работает над скоростью вывода: Ouro и Huginn здесь служат тестовыми моделями. Инженерам, оптимизирующим декодирование на GPU, может быть интересна сама схема: проверка кандидатов через последние проходы, проекция внутри выходного GEMM и единый статический CUDA-граф.
Как это применить
Прямого готового инструмента в источнике нет: о выпуске кода или моделей в аннотации не сказано. Практический путь, изучить полный текст статьи и воспроизвести метод на своей зацикленной модели. Для этого потребуется лёгкое дообучение, устраняющее рассогласование норм скрытых состояний на границе входа. Режим подбирается параметром tau: 0, точное жадное декодирование, больше нуля, проверка с допуском, inf, вариант с потерями без откатов.
Можно ли доверять
Это препринт на странице Hugging Face Papers, и пересказ опирается только на его аннотацию. В источнике не названы авторы и организации, не указаны оборудование (модель GPU) и размер батча, а также то, относительно какого именно базового варианта считаются ускорения 5,2, 6,8, 6,1, 8,4 и 10,6-12,5 раза, кроме обозначения «greedy-exact» (точное жадное декодирование). Метрика у «+16,9 пункта» тоже не названа. Все цифры, заявления самой статьи, независимой проверки в источнике нет.
Риски и подводные камни
Наибольшие ускорения (6,8 раза на Ouro-2.6B, 10,6-12,5 раза на Huginn-3.5B) получены в режиме tau = inf, то есть «с потерями»; цена по качеству в аннотации дана лишь через сравнение с обученным ранним выходом (+16,9 пункта). Точный режим tau = 0 совпадает с блочным декодированием K = T лишь с точностью до порядка редукции в bf16. Метод требует дообучения и привязан к конкретной реализации (единый статический CUDA-граф), так что перенос на другие модели и оборудование нужно проверять отдельно.