SpecSlot: пиксельный трансформер для картинок без раздувания глобального внимания
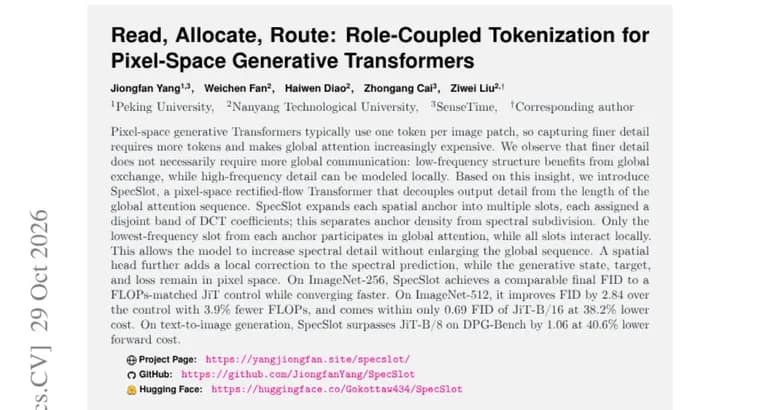
Пиксельные генеративные трансформеры обычно используют один токен на фрагмент (патч) изображения. Чем тоньше детали, тем больше нужно токенов, и тем дороже становится глобальное внимание. Авторы препринта отмечают, что более тонкая детализация не обязательно требует более широкого глобального обмена информацией: низкочастотная структура выигрывает от глобального обмена, а высокочастотные детали можно моделировать локально.
На этом наблюдении построена модель SpecSlot, пиксельный трансформер на основе rectified flow (выпрямленного потока). Она отделяет детализацию выхода от длины последовательности для глобального внимания. Каждая пространственная опорная точка (anchor) разворачивается в несколько слотов, и каждому слоту достаётся своя непересекающаяся полоса коэффициентов DCT (дискретного косинусного преобразования). Так плотность опорных точек отделяется от спектрального деления. В глобальном внимании участвует только слот с самой низкой частотой от каждой опорной точки, а локально взаимодействуют все слоты. Благодаря этому можно наращивать спектральную детализацию, не увеличивая глобальную последовательность. Дополнительно пространственная «голова» (spatial head) добавляет локальную поправку к спектральному предсказанию, а состояние генерации, цель и функция потерь остаются в пиксельном пространстве.
Результаты, о которых сообщают авторы. На ImageNet-256 SpecSlot достигает сопоставимого итогового FID с контрольной моделью JiT, подобранной по числу FLOPs, и при этом сходится быстрее; числовых значений для этого сравнения в аннотации нет. На ImageNet-512 модель улучшает FID на 2,84 относительно контрольной при 3,9% меньшем числе FLOPs, а от JiT-B/16 отстаёт лишь на 0,69 FID при стоимости ниже на 38,2%. В генерации по тексту SpecSlot обходит JiT-B/8 на DPG-Bench на 1,06 при прямом проходе на 40,6% дешевле.
Ключевые факты
- SpecSlot разворачивает каждую опорную точку изображения в несколько слотов, каждому из которых достаётся своя непересекающаяся полоса DCT-коэффициентов.
- В глобальном внимании участвует только самый низкочастотный слот каждой опорной точки; локально взаимодействуют все слоты, поэтому детализацию можно наращивать без роста глобальной последовательности.
- ImageNet-512: FID лучше контрольной модели JiT на 2,84 при 3,9% меньшем числе FLOPs; от JiT-B/16 отставание 0,69 FID при стоимости ниже на 38,2%.
- ImageNet-256: итоговый FID сопоставим с контрольной моделью JiT, сходимость быстрее.
- Генерация по тексту: на DPG-Bench модель опережает JiT-B/8 на 1,06 при прямом проходе на 40,6% дешевле.
Почему это важно
Стоимость глобального внимания растёт вместе с числом токенов, а в пиксельных генеративных трансформерах более тонкая детализация обычно требует больше токенов. SpecSlot предлагает развязать эти две вещи: детализацию наращивают через спектральные слоты, а глобальная последовательность остаётся прежней. Это исследовательский результат на бенчмарках ImageNet и DPG-Bench, а не готовый продукт.
Кому это важно
Исследователям генерации изображений в пиксельном пространстве и тем, кто сравнивает архитектуры с JiT. Идея интересна и всем, кого волнует цена внимания при росте разрешения.
Как это применить
Прямого практического применения в источнике нет: в аннотации не упоминаются код, веса или релиз. Для специалистов ценность пока в самой идее: назначать слотам полосы DCT-коэффициентов и пускать в глобальное внимание только низкочастотный слот. Прежде чем что-то внедрять, нужно дождаться полного текста статьи.
Можно ли доверять
Все цифры взяты из аннотации препринта и являются заявлениями самих авторов. Абсолютные значения FID для SpecSlot, контрольной модели и JiT-B/16 в аннотации не приведены, только разности. Для сравнения на ImageNet-256 нет числовых значений и величины ускорения сходимости. Слово «стоимость» в цифре 38,2% не определено (в других случаях речь о FLOPs и прямом проходе). Авторы и организации в аннотации не названы.
Риски и подводные камни
Выигрыши умеренные: на ImageNet-512 SpecSlot всё же уступает JiT-B/16 по FID на 0,69, а на ImageNet-256 качество лишь сопоставимо. Размеры моделей, бюджет обучения и железо в аннотации не указаны, поэтому честность сравнения по затратам проверить нельзя. Сравнения с латентными диффузионными моделями в аннотации нет.