SolarRenderer: нейросеть превращает структуру сцены в видео за четыре шага
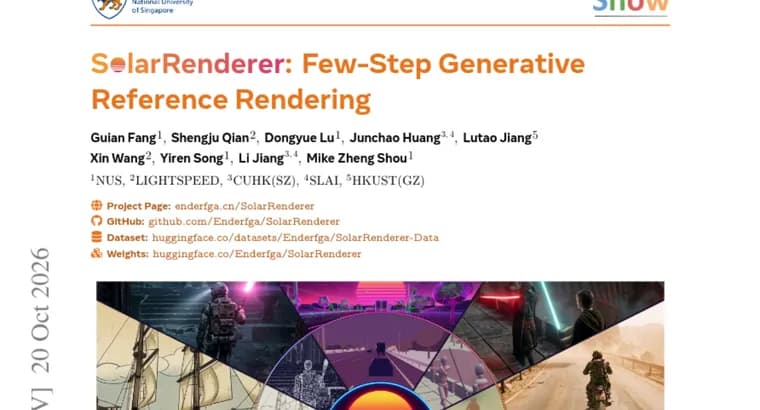
В статье на Hugging Face Papers представлен SolarRenderer, рендерер видео, который работает по заданной структуре сцены. Исходная идея: игровые движки и кодинг-агенты умеют задавать раскладку, движение и камеру сцены, но чтобы превратить такую грубую структуру в реалистичное видео, нужен рендерер, который и следует структуре, и достраивает внешний вид, оставленный открытым. По словам авторов статьи, существующие рендереры привязаны к представлению одного движка, требуют десятков шагов шумоподавления (denoising) или дорогой собственной дистилляции и обучаются на условиях, не выровненных с целевыми видео.
SolarRenderer адаптирует замороженную опорную модель MiniMax-H3 на 33 млрд параметров с помощью двух лёгких LoRA-адаптеров. Структурные видео подаются в «родной» канал опорных изображений (reference pathway) модели на позициях тех кадров, которые они описывают. При этом у них нет идентификатора типа, а описывают их только простым текстом, поэтому один управляющий LoRA способен следовать произвольным структурным представлениям.
Для ускорения берут заранее обученный четырёхшаговый LoRA, и структурно-направляемое согласование распределений (structure-guided distribution matching) позволяет рендерить за четыре шага, сохраняя выученное управление. Это в 12,3 раза быстрее, чем 50-шаговая выборка; в тексте не уточнено, о задержке или пропускной способности идёт речь, и на каком оборудовании. Блочно-каузальный (block-causal) вариант распространяет ту же конструкцию на потоковую генерацию и рендерит видео 768p в реальном времени.
Для обучения авторы собрали выровненный покадрово корпус из 136 тысяч клипов из игровых движков, симуляторов и YouTube-видео. Эксперименты проводились на тестовом наборе из того же распределения и на бенчмарке обобщения из 16 структурных представлений. По утверждению авторов, SolarRenderer показывает лучшие результаты на обоих и обобщается на 11 не встречавшихся при обучении представлений, включая скелеты поз, рисунки и облака точек.
Ключевые факты
- SolarRenderer, рендерер видео по структуре сцены: адаптирует замороженную опорную модель MiniMax-H3 на 33 млрд параметров двумя лёгкими LoRA.
- Один управляющий LoRA следует произвольным структурным представлениям: структурные видео подаются без идентификатора типа и описываются только текстом.
- Рендер за четыре шага, в 12,3 раза быстрее 50-шаговой выборки; блочно-каузальный потоковый вариант рендерит 768p в реальном времени.
- Обучение на покадрово выровненном корпусе из 136 тысяч клипов из игровых движков, симуляторов и YouTube.
- Авторы заявляют лучшие результаты на тесте из того же распределения и на бенчмарке из 16 представлений, обобщение, на 11 не виденных ранее, включая скелеты поз, рисунки и облака точек.
Почему это важно
Игровые движки и кодинг-агенты умеют задавать раскладку, движение и камеру сцены, но превращение такой структуры в реалистичное видео обычно упирается в привязку рендерера к одному движку и в десятки шагов генерации. SolarRenderer, по заявлению авторов, снимает оба ограничения: единый управляющий LoRA работает с разными структурными представлениями, а рендер занимает четыре шага, что в 12,3 раза быстрее 50-шаговой выборки.
Кому это важно
Исследователям генерации видео и управляемого рендеринга, а также командам, которые связывают игровые движки, симуляторы или агентов, генерирующих сцены, с нейросетевым видео. Интерес представляет и потоковый вариант, рендерящий 768p в реальном времени.
Как это применить
Из описания в статье напрямую применить ничего нельзя: в тексте не сказано, опубликованы ли веса, код или данные. Практически полезны сами идеи: подача структурных видео в родной канал опорных изображений опорной модели без идентификатора типа, лёгкие LoRA поверх замороженной модели и перевод её на четыре шага через структурно-направляемое согласование распределений.
Можно ли доверять
Это препринт с описанием, сделанным самими авторами. Утверждение о лучших результатах на обоих наборах не подкреплено в тексте названиями метрик, числами и базовыми методами. Условия измерения ускорения в 12,3 раза и реального времени (оборудование, частота кадров) не указаны, как и то, о задержке или пропускной способности идёт речь. Независимой проверки в материале нет.
Риски и подводные камни
Заявление об обобщении на 11 не виденных представлений нужно проверять на собственных данных: перечислены только скелеты поз, рисунки и облака точек. Модель опирается на крупную опорную модель MiniMax-H3 на 33 млрд параметров, поэтому требования к вычислениям могут быть заметными, но в тексте они не раскрыты. Доля клипов из каждого источника корпуса (игровые движки, симуляторы, YouTube) тоже не указана.