SO-Arena: лучшая модель System One оказалась лишь седьмой по надёжности
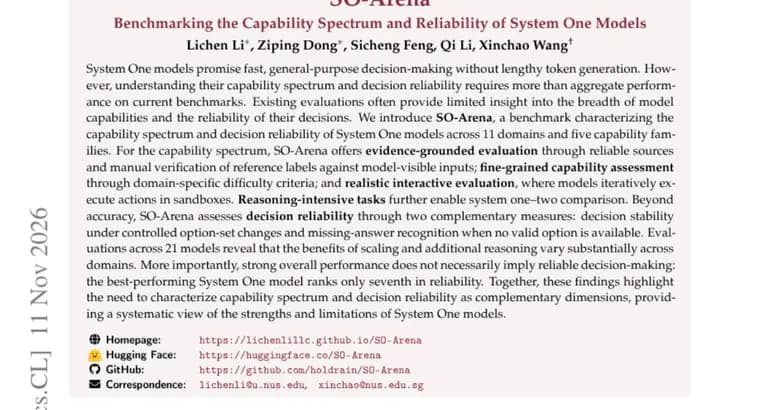
Модели System One обещают быстрое решение общих задач без длинной генерации токенов. Авторы работы считают, что понять их возможности и надёжность решений по совокупным оценкам на существующих бенчмарках нельзя: такие оценки дают ограниченное представление и о широте способностей, и о надёжности выбора. Для этого они предложили бенчмарк SO-Arena, который охватывает 11 областей и пять семейств способностей.
Часть бенчмарка, описывающая спектр способностей, строится на трёх приёмах. Во-первых, оценка опирается на проверяемые данные: доказательства берутся из надёжных источников, а эталонные ответы вручную сверяются с тем, что модель видит на входе. Во-вторых, способности оцениваются детально, по критериям сложности, заданным для каждой области отдельно. В-третьих, есть реалистичная интерактивная проверка, где модели шаг за шагом выполняют действия в песочницах. Задачи, требующие рассуждений, позволяют дополнительно сравнивать System One с System Two.
Отдельно SO-Arena измеряет надёжность решений, причём не только точность. Для этого есть две взаимодополняющие меры. Первая, устойчивость решения при контролируемых изменениях набора вариантов ответа. Вторая, умение распознать отсутствие ответа, когда среди вариантов нет подходящего.
Оценка 21 модели показала две вещи. Выигрыш от увеличения масштаба и от дополнительных рассуждений заметно различается по областям. И главное: сильная общая производительность не обязательно означает надёжные решения, лучшая по результатам модель System One занимает лишь седьмое место по надёжности. Вывод авторов: возможности и надёжность решений нужно описывать как два дополняющих друг друга измерения, чтобы получить системную картину сильных и слабых сторон моделей System One.
Ключевые факты
- SO-Arena, бенчмарк для моделей System One (быстрые решения без длинной генерации токенов): 11 областей и пять семейств способностей.
- Надёжность измеряется двумя мерами сверх точности: устойчивость решения при изменении набора вариантов и распознавание ситуации, когда подходящего ответа нет.
- В бенчмарк входят интерактивные задачи в песочницах, где модели шаг за шагом выполняют действия, и эталонные ответы, проверенные вручную.
- По итогам оценки 21 модели лучшая модель System One занимает только седьмое место по надёжности.
- Выигрыш от масштаба и дополнительных рассуждений сильно зависит от области.
Почему это важно
Обычно модели сравнивают по совокупной точности на готовых тестах. Авторы SO-Arena показывают, что это не отражает главного: модель с сильным общим результатом может принимать ненадёжные решения. Лучшая по результатам модель System One оказалась только седьмой по надёжности. Это довод в пользу того, чтобы оценивать возможности и надёжность отдельно, как два измерения. Полезен и второй вывод: отдача от увеличения размера модели и от дополнительных рассуждений заметно отличается между областями.
Кому это важно
Исследователям, которые строят и сравнивают бенчмарки для быстрых моделей. Командам, которые выбирают модель для решений, где важен стабильный выбор среди вариантов, а не только средняя точность. Тем, кто изучает, когда стоит доплачивать за масштаб и рассуждения, а когда выигрыш мал.
Как это применить
Из описания в источнике можно взять идеи для собственных проверок. Стоит смотреть не только на точность, но и на то, меняется ли ответ модели при контролируемом изменении набора вариантов. Стоит проверять, умеет ли модель сказать, что подходящего ответа нет. Эталонные ответы полезно сверять вручную с тем, что модель реально видит. Сведений о доступности кода и данных бенчмарка в источнике нет.
Можно ли доверять
Это краткая аннотация исследовательской работы с Hugging Face. В ней нет имён авторов и организаций, названий проверенных моделей, перечня 11 областей и пяти семейств способностей, а также числовых результатов, кроме места «седьмое». Непонятно, лучшая ли модель выделена по точности или по сводному баллу: сказано только «лучшая по результатам». Утверждения авторов о надёжности и масштабировании нельзя проверить без полного текста и данных.
Риски и подводные камни
Вывод о седьмом месте по надёжности опирается на конкретный набор моделей, задач и мер надёжности SO-Arena. Он не обязательно переносится на другие тесты. Без названий моделей и числовых оценок сделать практический выбор по этому источнику нельзя. Граница между System One и System Two в аннотации не определена подробно: System One описан как быстрое принятие решений без длинной генерации токенов.