ServiceNow CoreAI представила AutoSynthData: синтетические данные для корпоративных агентов
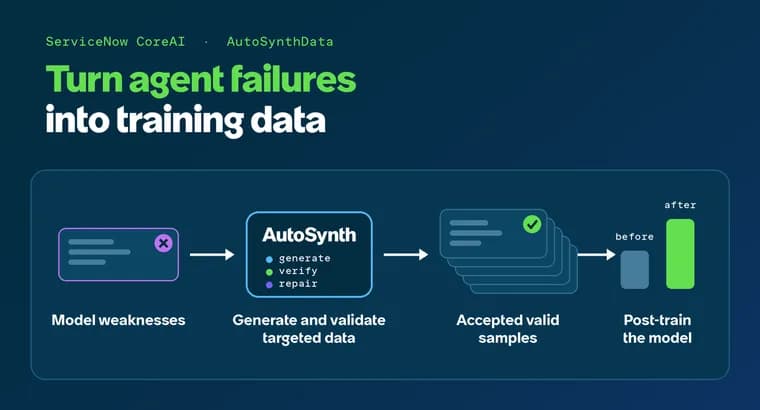
ServiceNow CoreAI опубликовала в блоге Hugging Face описание AutoSynthData: конвейера, который превращает слабые места модели в корпоративной среде в обучающие данные. Исходная проблема в том, что даже сильная в целом модель может плохо справляться с конкретной средой: с отдельным рабочим процессом, сочетанием инструментов или ограничением, которое она не соблюдает. Одного провала для обучения мало, нужно много новых задач на ту же способность, и каждая должна быть выполнимой в среде, напоминать реальный запрос и иметь надёжную проверку результата.
AutoSynthData использует провалы целевой модели и успехи более сильной модели-учителя, чтобы решить, чему учить модель дальше, затем генерирует и проверяет новые задачи. По мере улучшения модели учебная программа смещается к тому, что ей всё ещё даётся трудно. Конвейер авторы иллюстрируют на EnterpriseOps Gym (Malay et al., 2026), используя опубликованный набор данных.
Задача определяется как тройка: системная спецификация (инструкции, политики среды, при необходимости начальное состояние, например заполненная база данных), пользовательский запрос и верификатор. У задачи три желаемых свойства: выполнимость (в среде существует хотя бы одна траектория, удовлетворяющая запросу), реалистичность (запрос похож на то, что попросил бы пользователь) и сложность (задача выявляет слабость текущего агента; уже надёжно решаемые задачи почти не дают сигнала). Верификатор должен быть согласованным, строгим (отвергает неверные траектории) и полным (принимает любые корректные решения, а не одну эталонную траекторию).
Сначала целевая модель и более сильный учитель прогоняются на оценочных задачах. Из этих прогонов выделяют проверяемую способность, задействованные инструменты и структуру процесса, место провала модели и то, как справляется учитель, свойства корректного итогового состояния и параметры, которые можно менять, не теряя суть способности. Выводы сводятся в обезличенные карточки спецификации способностей. Генератор получает только карточки, а не исходные запросы, сущности, траектории и детали верификаторов оценочных задач, и создаёт новые задачи с другими запросами, состояниями и путями решения. Он варьирует сущности, начальное состояние среды, состав процесса, сочетания инструментов, формулировки и сложность. Для каждой задачи учитель показывает успешную траекторию; для дообучения с учителем (SFT) эти демонстрации учат модель применять способность в новых ситуациях.
Набор строится в две фазы. В фазе target параллельные исполнители создают базовые образцы: каждый кандидат проходит валидацию, выполнение, оценку решателем и исправление. В фазе multiply из принятых образцов делают новые варианты со своим запросом, состоянием среды, конфигурацией сущностей, эталонной траекторией и верификатором; они проходят те же проверки. Размноженный образец не может порождать следующий размноженный, что привязывает расширение к проверенному ядру и ограничивает дрейф. Архитектура разделена на общий контроллер (генерация, контроль качества, охват, сборка набора) и адаптер конкретной среды (выполнение, управление задачами и состоянием, воспроизведение эталона, детерминированная проверка, запуск решателей, профилирование задач).
Контроль качества двухуровневый. На уровне образца сначала измеряется сложность: в использованной конфигурации предпочтение отдаётся задачам, которые целевая модель решает не более чем в одной из трёх попыток, а более сильный решатель решает хотя бы в двух из трёх. Затем идут положительная проверка (эталонная траектория выполняется в среде, итоговое состояние сверяется с верификатором кандидата) и отрицательная (части ожидаемого результата искажаются, и проверяется, что такие состояния верификатор больше не пропускает; так ловят слабые верификаторы). Провалившиеся кандидаты попадают к критику, который ищет противоречивое состояние, невозможные процессы, ошибки построения задачи, плохие эталонные траектории, слабую логику верификатора или несоответствие целевой способности. Его выводы направляют точечное исправление с фиксированным пределом повторов, после чего проверки запускаются заново.
На уровне пакета мета-обзор разбирает принятые и отклонённые образцы и поведение генерации: какие семейства задач представлены слишком часто, каких измерений способностей не хватает, повторяются ли однотипные примеры, не проваливаются ли одни и те же цели, есть ли системные проблемы в критике. Контроллер отслеживает охват принятого набора, снижает генерацию в избыточно представленных областях и направляет усилия на пробелы.
Итоговая идея: синтез данных рассматривается как поиск задач у границы возможностей целевой модели, достаточно трудных, чтобы выявлять слабости, но достаточно решаемых, чтобы учитель давал надёжные демонстрации. После дообучения модель снова оценивают в той же среде; уверенно решаемые задачи теряют ценность, а устойчивые провалы указывают, что учить дальше. Текст обрывается на фразе о том, что эксперименты авторов сосредоточены на SFT.
Ключевые факты
- AutoSynthData по провалам целевой модели и успехам более сильной модели-учителя выбирает, чему учить дальше, а затем генерирует и проверяет новые задачи для корпоративных агентов.
- Задача = системная спецификация + пользовательский запрос + верификатор; генератор получает только обезличенные карточки способностей, а не исходные оценочные задачи.
- Две фазы: target (базовые образцы) и multiply (варианты принятых образцов); размноженный образец не может порождать новые, что ограничивает дрейф.
- Контроль качества: фильтр сложности (целевая модель решает не более чем в 1 из 3 попыток, сильный решатель не менее чем в 2 из 3), положительная и отрицательная проверки верификатора, критик и ограниченное число исправлений.
- Мета-обзор на уровне пакета следит за охватом и разнообразием; пример построен на наборе EnterpriseOps Gym (Malay et al., 2026).
Почему это важно
Корпоративным компаниям нужны агенты, которые хорошо работают в их собственных системах, правилах и данных, а общая сила модели этого не гарантирует. AutoSynthData предлагает способ превратить конкретные слабые места модели в масштабируемый набор проверяемых учебных задач. Ключевая идея, на которой строят подход авторы, в том, что синтез данных ведётся у границы возможностей модели и перестраивается по мере её улучшения.
Кому это важно
Командам, которые дообучают модели под конкретные корпоративные среды и агентные сценарии, а также исследователям синтетических данных и верификаторов для обучения агентов. Подход описан как работающий поверх конкретной среды через адаптер, поэтому он интересен тем, кто строит свои среды с инструментами и состоянием.
Как это применить
Из текста можно взять схему: прогнать целевую модель и более сильного учителя на оценочных задачах, свести найденные пробелы в обезличенные карточки способностей, сгенерировать задачи и пропустить их через положительную и отрицательную проверки, критика и ограниченное число исправлений. Фильтр сложности в описанной конфигурации: целевая модель решает задачу не более чем в одной из трёх попыток, сильный решатель решает хотя бы в двух из трёх. Проиллюстрирован подход на опубликованном наборе EnterpriseOps Gym; о доступности самого AutoSynthData в видимой части текста не сказано.
Можно ли доверять
Это блог-пост самой команды ServiceNow CoreAI, то есть описание собственного метода авторами. В доступной части материала нет экспериментальных результатов, оценок на бенчмарках или сравнений до и после дообучения, поэтому судить о реальной пользе метода по этому тексту нельзя: приведено лишь описание конструкции конвейера. Названия целевой и сильной модели тоже не указаны.
Риски и подводные камни
Качество всего подхода зависит от верификаторов: слабый может поощрять неверное поведение, слишком строгий наказывать корректные решения, и именно поэтому в конвейере предусмотрены отрицательные проверки. Авторы также отмечают риск повторяющегося или несбалансированного набора даже при корректных отдельных образцах, для чего введён обзор на уровне пакета. Расширение за счёт размножения ограничено одним поколением, чтобы не допустить дрейфа. Конкретные пороги (например, три попытки) относятся к использованной конфигурации и не обязательно универсальны.