Исследователи предложили PoS: ИИ-агенты с явными состояниями убеждений
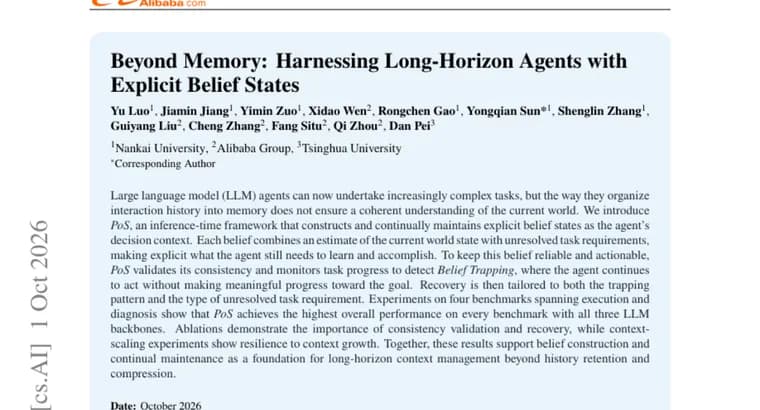
Авторы статьи исходят из того, что агенты на основе больших языковых моделей берутся за всё более сложные задачи, но способ, которым они складывают историю взаимодействия в память, не гарантирует связного понимания текущего состояния мира.
В ответ они предлагают PoS, фреймворк, работающий на этапе вывода (inference-time): он строит и постоянно поддерживает явные состояния убеждений (belief states) и использует их как контекст для принятия решений агентом. Каждое такое убеждение объединяет оценку текущего состояния мира с нерешёнными требованиями задачи, то есть прямо фиксирует, что агенту ещё нужно узнать и выполнить.
Чтобы убеждение оставалось надёжным и пригодным для действий, PoS проверяет его согласованность и следит за ходом выполнения задачи. Так система обнаруживает «застревание в убеждении» (Belief Trapping), ситуацию, когда агент продолжает действовать, но не продвигается к цели. После обнаружения запускается восстановление, которое подбирается под конкретный паттерн застревания и под тип нерешённого требования задачи.
Эксперименты проведены на четырёх бенчмарках, охватывающих выполнение задач и диагностику, с тремя языковыми моделями. По заявлению авторов, PoS показывает лучший общий результат на каждом бенчмарке с каждой из трёх моделей. Абляции (отключение отдельных компонентов) показывают важность проверки согласованности и восстановления, а эксперименты с ростом контекста, устойчивость метода к его увеличению. Авторы делают вывод, что построение и непрерывное поддержание убеждений может служить основой управления контекстом в длинных задачах, шире, чем простое хранение и сжатие истории.
Ключевые факты
- PoS, фреймворк этапа вывода: строит и постоянно обновляет явные состояния убеждений как контекст для решений агента.
- Каждое убеждение сочетает оценку текущего состояния мира с нерешёнными требованиями задачи.
- PoS проверяет согласованность убеждения и ловит «застревание в убеждении» (Belief Trapping), действия без заметного продвижения к цели; восстановление зависит от паттерна застревания и типа требования.
- Авторы сообщают о лучшем общем результате на всех четырёх бенчмарках (выполнение и диагностика) со всеми тремя моделями.
- Абляции подтверждают значимость проверки согласованности и восстановления; эксперименты с ростом контекста показывают устойчивость.
Почему это важно
Работа бьёт в известную проблему длинных задач для агентов: накопленная история взаимодействия сама по себе не даёт агенту связной картины происходящего. Авторы предлагают не просто хранить и сжимать историю, а вести явную модель того, что агент знает о мире и что ему ещё предстоит выяснить и сделать. Если выводы подтвердятся, это сдвиг в подходе к управлению контекстом агентов.
Кому это важно
Разработчикам ИИ-агентов, которые сталкиваются с зацикливанием и потерей хода работы в длинных задачах, а также исследователям памяти и управления контекстом для языковых моделей. Метод описан как работающий на этапе вывода, то есть он надстраивается над моделями.
Как это применить
Из описания видна общая идея, которую можно переносить в свои системы: вести отдельное явное состояние (оценка мира плюс список нерешённых требований), проверять его согласованность, следить за прогрессом и при застревании запускать восстановление, подобранное под ситуацию. Готовых деталей реализации, кода и условий использования в описании работы нет, поэтому это ориентир для идеи, а не инструкция.
Можно ли доверять
Все результаты, заявления авторов в аннотации статьи. В описании не названы ни сами бенчмарки, ни три используемые модели, нет числовых показателей, величины улучшения и базовых методов для сравнения, не указаны авторы и организации. Формулировка «лучший общий результат» поэтому не поддаётся проверке по этому тексту; для оценки нужна полная статья.
Риски и подводные камни
В описании не указаны ни затраты вычислений, времени и стоимости на поддержание состояний убеждений, ни диапазон роста контекста в экспериментах, ни ограничения метода. Остаётся неясным, насколько подход переносится за пределы четырёх протестированных бенчмарков и трёх моделей и как он ведёт себя, если сама оценка состояния мира окажется ошибочной.