Self-HPO поднял долю решённых задач у Qwen3.5-35B-A3B с 57,8% до 64,8%
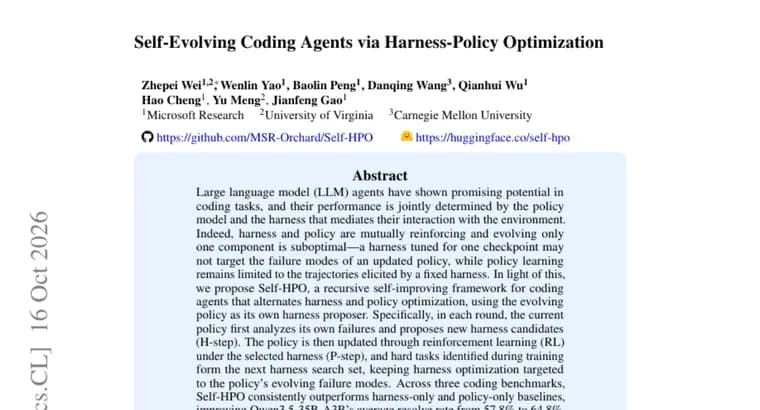
В статье предложен Self-HPO (Self-Evolving Coding Agents via Harness-Policy Optimization), рекурсивный самоулучшающийся фреймворк для кодовых агентов. Исходная мысль: качество агента определяется двумя частями сразу, моделью-политикой и обвязкой (harness), то есть слоем, который посредничает между моделью и средой. Авторы считают, что они усиливают друг друга, а развивать только одну из них неоптимально: обвязка, настроенная под один чекпойнт модели, может не попадать в слабые места обновлённой политики, а обучение политики ограничено траекториями, которые вызывает фиксированная обвязка.
Поэтому Self-HPO чередует два шага, используя развивающуюся политику как собственного автора предложений для обвязки. В каждом раунде текущая политика сначала разбирает собственные провалы и предлагает новые варианты обвязки (H-шаг). Затем политику обновляют с помощью обучения с подкреплением (RL) под выбранной обвязкой (P-шаг). Трудные задачи, выявленные во время обучения, образуют следующий набор для поиска обвязки, так её оптимизация остаётся нацеленной на меняющиеся слабые места политики.
На трёх бенчмарках по кодингу Self-HPO, по утверждению авторов, стабильно превосходит базовые варианты, где оптимизируется только обвязка или только политика. Средняя доля решённых задач (resolve rate) у Qwen3.5-35B-A3B выросла с 57,8% до 64,8%, причём выигрыш переносится и на условия вне обучающего распределения.
Дополнительный анализ показывает: оба оптимизированных компонента сохраняют прирост даже в паре с исходными (базовыми) аналогами, а их совместный прирост превышает сумму отдельных. Self-HPO также повышает надёжность (Pass@1) и расширяет границу возможностей (Pass@k) по сравнению с базовым агентом. Наконец, если в роли автора предложений для обвязки взять более сильную внешнюю модель (в качестве примера названа Opus 4.8), тот же фреймворк даёт ещё один прирост качества.
Ключевые факты
- Self-HPO чередует два шага: H-шаг (политика разбирает свои провалы и предлагает новые варианты обвязки) и P-шаг (обучение политики с подкреплением под выбранной обвязкой).
- Трудные задачи, найденные при обучении, формируют следующий набор для поиска обвязки, так что оптимизация нацелена на текущие слабые места политики.
- На трёх бенчмарках по кодингу средняя доля решённых задач Qwen3.5-35B-A3B выросла с 57,8% до 64,8%; прирост, по словам авторов, переносится на условия вне обучающего распределения.
- Совместный прирост обвязки и политики, по утверждению авторов, превышает сумму их отдельных приростов; растут и Pass@1, и Pass@k.
- Если поручить предлагать обвязку более сильной внешней модели (например, Opus 4.8), качество вырастает ещё.
Почему это важно
Обычно агентов улучшают с одной стороны: либо подбирают обвязку (подсказки, инструменты, правила взаимодействия со средой), либо дообучают модель. Self-HPO, попытка делать обе вещи в одном цикле, где сама модель разбирает свои ошибки и предлагает улучшения обвязки. По заявлению авторов, средняя доля решённых задач у Qwen3.5-35B-A3B растёт с 57,8% до 64,8%, а совместный эффект больше суммы отдельных.
Кому это важно
Исследователям и командам, которые строят кодовых агентов и дообучают открытые модели с помощью RL, а также тем, кто вручную настраивает обвязку под конкретную модель и сталкивается с тем, что настройка устаревает после обновления чекпойнта.
Как это применить
Из пересказа статьи прямого рецепта не следует: о коде, выпуске модели или лицензии в тексте не говорится. Идею можно взять как схему: чередовать раунды поиска обвязки на трудных задачах и раунды RL под выбранной обвязкой, а трудные задачи из обучения использовать как следующий поисковый набор. Авторы также показывают вариант с сильной внешней моделью в роли автора предложений для обвязки.
Можно ли доверять
Это статья с описанием метода, все цифры, заявления самих авторов из аннотации. Три бенчмарка в тексте не названы, показателей по каждому из них нет, есть только среднее. Не указано и то, служит ли 57,8% показателем исходного агента или более сильного базового варианта, а также использует ли результат 64,8% внешнюю модель вроде Opus 4.8. Размер дополнительного прироста с внешней моделью не приведён. Для оценки нужны полный текст статьи и независимая проверка.
Риски и подводные камни
Результат подтверждён на одной названной модели (Qwen3.5-35B-A3B) и трёх бенчмарках, поэтому перенос на другие модели и задачи не гарантирован. Число раундов, затраты вычислений и стоимость в аннотации не указаны, так что оценить практичность метода по ней нельзя. Утверждение, что совместный прирост превышает сумму отдельных, и вывод о выигрыше вне обучающего распределения исходят от авторов и требуют проверки на полных данных.