Sakana AI предложила MASS: модель учится на работе своей команды агентов
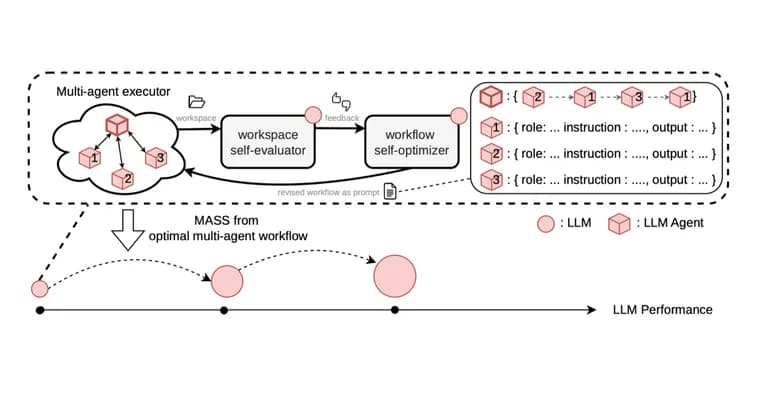
В Sakana AI (работа выполнена во время стажировки в компании) описали метод Multi-Agent Self-Supervision (MASS), цикл рекурсивного самоулучшения (RSI), в котором одна и та же языковая модель играет три роли: исполнителя задачи, оптимизатора рабочих процессов команды и оценщика. Исходный тезис авторов: чтобы выйти за пределы накопленных человечеством знаний, ИИ может оказаться лучшим из доступных оптимизаторов и оценщиков самого себя, потому что на этой границе даже эксперты-люди с трудом оценивают результат и направляют прогресс, особенно в непроверяемых задачах.
Как устроен цикл. Оптимизатор ищет лучший командный рабочий процесс (workflow, письменный план того, как агенты делят задачу, обмениваются результатами и проверяют друг друга), опираясь на обратную связь оценщика; пока идёт этот внутренний цикл, веса модели не меняются. Затем внешний цикл дообучает исполнителя на запусках «лучшей по собственной оценке» команды, и обновлённая модель снова занимает все три роли. Для каждой обучающей задачи хранится «чемпион», лучший найденный на данный момент процесс. Чемпионов запускают с несколькими случайными зёрнами, текущая модель ранжирует итоговые рабочие пространства, и остаются траектории с высшим рангом; в них записаны сообщения, вызовы инструментов и их результаты у оркестратора и субагентов. Из обучающего промпта оркестратора сам процесс убирают, чтобы модель училась организовывать работу по самой задаче. Задачи непроверяемые: автоматического правила-проверки нет, обучением управляет только самооценка, правильность которой неизвестна. GPT-5.5 и Claude Opus 4.8 оценивают готовую работу отдельно и служат лишь внешней меркой прогресса: их суждения от MASS скрыты.
Пример из статьи, финансовый процесс: данные, признаки, моделирование, бэктест, аудит, сверка, отчёт. Контракт специалиста по данным требует отчёта о проверках, что в бэктест не просочилась информация из будущего и границы обучающей, валидационной и тестовой выборок по времени соблюдены.
Эксперимент. Авторы провели два полных раунда MASS, стартуя с Qwen3.6-27B в среде кодового агента qwen-code. Синтетический набор содержит 12 задач из финансов, робототехники и фармацевтики; в каждой нужны код, количественные результаты и исследовательский отчёт. На трёх синтетических тестовых задачах доля побед над базовой моделью выросла с 53,9% после первого раунда до 69,9% после второго, а модель второго раунда выигрывает у модели первого раунда в 60,8% сравнений. На публичных бенчмарках MLR-Bench, DSBench, ScienceAgentBench и AstaBench оценка на выходной токен после двух раундов достигает 1,2-1,6 от уровня базовой модели. Выигрыш сильнее всего на четырёх исследовательских бенчмарках, похожих на обучающие задачи; на Terminal-Bench 2.0 показатель составляет 0,96 от базового, на SWE-bench Verified, 0,94.
Что ещё нашли. Обучение только на траекториях решения задач улучшило и оптимизатор, и оценщика (обобщение ролей), что, по мнению авторов, делает цикл устойчивым: согласие оценщика с сильными внешними судьями выросло с 73% до 93% за три цикла. Авторы сами оговаривают, что сравнение «оптимизатор быстрее находит рабочие процессы» не вполне честное, поскольку меняются и оптимизатор, и оптимизируемая модель; в контрольном опыте базовая модель с процессами первого раунда выигрывает у базовой модели с исходными процессами в 64% сравнений. Траектории мультиагентных систем оказались эффективнее одиночных на токен обучения: модель M+ (первый раунд MASS) достигает 68,3% побед над базовой после 28,8 млн обучающих токенов, а S++ (одиночные траектории), 64,0% после 42 млн, то есть MASS нужно на 31% меньше токенов. Сильные внешние судьи предпочитают работу мультиагентных систем в 85,1% сравнений с одиночными, при этом командные запуски в среднем порождают примерно в 2,4 раза больше токенов.
Узкое место и шум. Когда базовую модель оставили решать задачи, а оценщика заменили на более сильную модель (GPT-5.5), выигрыш был небольшим; если заменить и оптимизатора, выигрыш стал большим. Строго гомогенный цикл всё равно находит выигрышные процессы для 11 из 12 задач, просто дольше. Отсюда авторы предполагают, что при ограниченном бюджете оптимизатор стоит приоритизировать над оценщиком. Поиск процессов шумный, и оптимизатору, возможно, понадобится аналог планировщика скорости обучения для стабилизации поиска в текстовом пространстве. По ходу оптимизации лучший процесс всё сильнее кодирует информацию о задаче в контрактах и передачах (hops) и всё слабее, в ролях и инструкциях.
Ключевые факты
- MASS, цикл рекурсивного самоулучшения, где одна модель одновременно исполнитель, оптимизатор рабочих процессов команды агентов и оценщик; дообучается она на запусках собственной «лучшей по самооценке» команды.
- На Qwen3.6-27B доля побед над базовой моделью на трёх синтетических тестовых задачах выросла с 53,9% после первого раунда до 69,9% после второго; после двух раундов на четырёх исследовательских бенчмарках оценка на выходной токен достигла 1,2, 1,6 от базовой.
- На Terminal-Bench 2.0 и SWE-bench Verified оценка на выходной токен чуть ниже базовой: 0,96 и 0,94 соответственно.
- Мультиагентные траектории эффективнее одиночных: 68,3% побед после 28,8 млн обучающих токенов против 64,0% после 42 млн, то есть на 31% меньше токенов.
- Узкое место цикла, по наблюдению авторов, оптимизатор, а не оценщик; поиск процессов шумный, а согласие оценщика с внешними судьями выросло с 73% до 93%.
Почему это важно
Рекурсивное самоулучшение, попытка заставить модель расти там, где у людей нет надёжного эталона: в непроверяемых задачах, где нет автоматической проверки результата. MASS предлагает для этого конкретный механизм: сначала команда агентов оптимизирует свой рабочий процесс при неизменных весах, затем её лучший опыт «вплавляется» в веса одной общей модели. Результат показывает, что на исследовательских задачах такая замкнутая самооценка даёт измеримый прирост без обращения к внешним оценкам при обучении. Авторы также формулируют практические наблюдения: ценность мультиагентных траекторий выходит за рамки масштабирования на этапе вывода, а слабый оптимизатор может не суметь «переварить» качественную обратную связь сильного оценщика.
Кому это важно
Исследователям рекурсивного самоулучшения и обучения на синтетических данных; командам, которые строят мультиагентные системы и подбирают для них схемы работы и контракты между агентами; тем, кто дообучает открытые модели на собственных траекториях агентов в условиях, где проверить ответ автоматически нельзя.
Как это применить
Из текста можно вынести несколько рабочих идей. Во-первых, явный письменный план команды (роли, порядок вызовов, контракты на то, что агент обязан установить и передать дальше, как проверка отсутствия утечки будущих данных в бэктесте) добавляется в промпт и может итеративно переписываться. Во-вторых, для обучения на траекториях стоит запускать лучший процесс с несколькими случайными зёрнами и оставлять только высокоранжированные запуски. В-третьих, авторы предполагают, что при ограниченном бюджете улучшать оптимизатор полезнее, чем оценщика. В доступном тексте не упоминается публикация кода, весов или данных, поэтому воспроизвести результат по одному лишь описанию придётся самостоятельно.
Можно ли доверять
Это собственная публикация Sakana AI о работе, выполненной во время стажировки в компании; цифры о результатах идут от авторов и не подтверждены независимым источником. В пользу методики: внешние оценки GPT-5.5 и Claude Opus 4.8 используются только для измерения прогресса и скрыты от обучения, а авторы сами оговаривают, что одно из сравнений не вполне честное, и добавляют контрольный опыт. Ограничения: результаты получены на одной базовой модели (Qwen3.6-27B), заявлений о других моделях и о системах фронтирного масштаба нет; метрика «оценка на выходной токен» дана отношением к базовой модели, абсолютные значения бенчмарков в видимом тексте не приведены; не указано, чьими суждениями (самой модели или внешних судей) получены доли побед в основной таблице; обучающее самосуждение, как признают авторы, имеет неизвестную правильность.
Риски и подводные камни
Выигрыш неравномерен: он сильнее всего на исследовательских бенчмарках, похожих на обучающие задачи, а на Terminal-Bench 2.0 и SWE-bench Verified оценка на токен чуть ниже базовой (0,96 и 0,94). Командные запуски порождают в среднем примерно в 2,4 раза больше токенов, чем одиночные. Поиск процессов шумный: добраться до хорошего процесса и стабильно улучшать его, разные задачи, а оптимизатору, возможно, понадобится аналог планировщика скорости обучения. Сравнение скорости поиска между циклами нечестное само по себе, поскольку меняются и оптимизатор, и оптимизируемая модель. Наконец, весь цикл опирается на самооценку, правильность которой заранее неизвестна, так что накопление ошибки оценщика остаётся открытым вопросом.
«За пределами крайних границ человеческой мысли.»
— Одиссей в «Улиссе» Теннисона, цитата из статьи Sakana AI