RynnUnify: представлена единая 16B-модель для роботов, понимающая мир и планирующая по видео
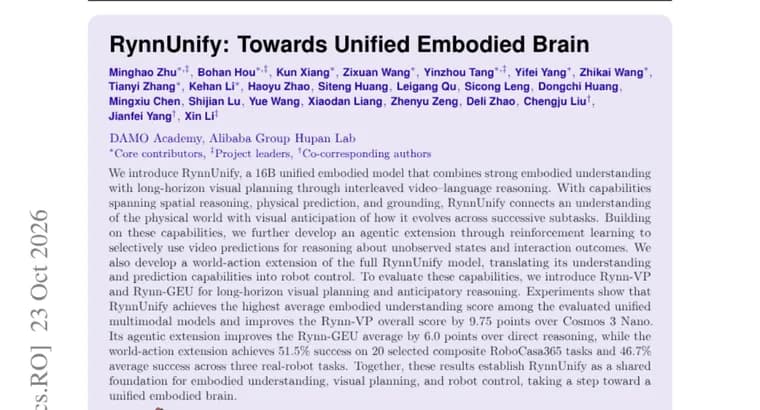
Авторы препринта представили RynnUnify, единую модель для воплощённого ИИ (embodied model) размером 16B. Она объединяет сильное понимание физического мира с долгосрочным визуальным планированием через чередующиеся рассуждения над видео и текстом. Заявленные возможности, пространственные рассуждения, предсказание физических процессов и привязка объектов (grounding). Модель связывает понимание мира с визуальным предвидением того, как он будет меняться от подзадачи к подзадаче.
На этой основе авторы разработали два расширения. Первое, агентное: оно обучено с помощью обучения с подкреплением и выборочно использует видеопрогнозы, чтобы рассуждать о ненаблюдаемых состояниях и последствиях взаимодействий. Второе, расширение «мир, действие» (world-action) на базе полной RynnUnify: оно переводит способности понимания и предсказания в управление роботом.
Для оценки авторы ввели два новых бенчмарка: Rynn-VP (долгосрочное визуальное планирование) и Rynn-GEU (предвосхищающие рассуждения). По их данным, RynnUnify показывает самый высокий средний балл по пониманию воплощённых сцен среди оценённых единых мультимодальных моделей и улучшает общий балл на Rynn-VP на 9,75 пункта относительно Cosmos 3 Nano. Агентное расширение повышает средний результат на Rynn-GEU на 6,0 пункта по сравнению с прямым рассуждением. Расширение «мир, действие» достигает 51,5% успеха на 20 отобранных составных задачах RoboCasa365 и в среднем 46,7% успеха на трёх задачах с реальным роботом.
Авторы заключают, что результаты делают RynnUnify общей основой для понимания, визуального планирования и управления роботом и приближают «единый воплощённый мозг».
Ключевые факты
- RynnUnify, единая воплощённая модель на 16B, объединяющая понимание физического мира и долгосрочное визуальное планирование через чередующиеся рассуждения над видео и текстом.
- Агентное расширение, обученное с подкреплением, выборочно использует видеопрогнозы; на Rynn-GEU оно даёт +6,0 пункта к среднему результату против прямого рассуждения.
- На новом бенчмарке Rynn-VP общий балл выше на 9,75 пункта, чем у Cosmos 3 Nano; по пониманию сцен, лучший средний балл среди оценённых единых мультимодальных моделей.
- Расширение «мир, действие» для управления роботом: 51,5% успеха на 20 составных задачах RoboCasa365 и в среднем 46,7% на трёх задачах с реальным роботом.
Почему это важно
Работа пытается собрать в одной модели то, что обычно разнесено по разным системам: понимание сцены, предсказание её развития в видео и управление роботом. Авторы называют это шагом к «единому воплощённому мозгу». Это заявка авторов, а не установленный факт.
Кому это важно
Исследователям робототехники и воплощённого ИИ, работающим над мультимодальными моделями, видеопрогнозированием и политиками управления. Также тем, кто следит за бенчмарками долгосрочного планирования: авторы вводят Rynn-VP и Rynn-GEU.
Как это применить
Из текста источника не следует практических шагов: в нём нет сведений о коде, весах или лицензии. Пока это описание подхода и результатов; применимость придётся оценивать по полной статье.
Можно ли доверять
Все результаты, собственные заявления авторов препринта. Для двух сравнений названы лишь разницы в пунктах (9,75 и 6,0), исходные значения не приведены. Для показателей 51,5% и 46,7% нет сравнения с другими методами, а сравниваемые единые мультимодальные модели, кроме Cosmos 3 Nano, не названы. Бенчмарки Rynn-VP и Rynn-GEU введены самими авторами.
Риски и подводные камни
Неясно, является ли 16B полным числом параметров или активными, какие базовая модель и данные использовались. Не описаны три реальные задачи робота и оборудование. Успех около 51,5% и 46,7% говорит, что надёжность управления пока далека от полной, хотя без базовых значений для сравнения оценить это точнее нельзя.