RSI Arena: десять ИИ-агентов сами дообучили Nemotron 3.5 Lightning
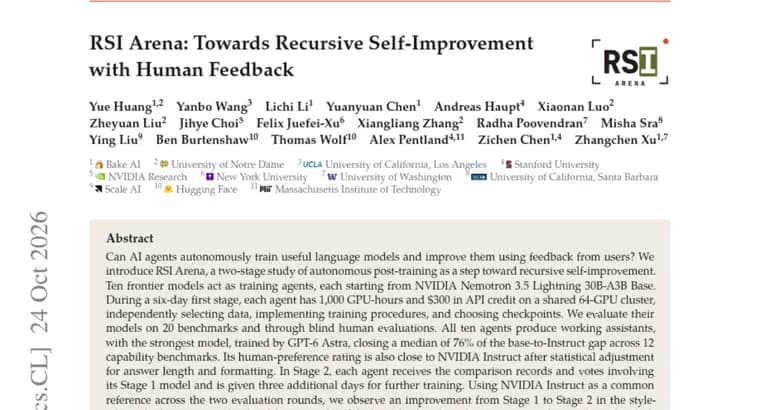
Авторы препринта задаются вопросом: могут ли ИИ-агенты самостоятельно обучить полезную языковую модель и затем улучшить её по отзывам пользователей. Для этого они представили RSI Arena, двухэтапное исследование автономного дообучения (post-training) как шага к рекурсивному самоулучшению.
В эксперименте десять передовых моделей выступают агентами-тренерами. Каждый стартует с одной и той же базовой модели NVIDIA Nemotron 3.5 Lightning 30B-A3B Base. На первом этапе, длившемся шесть дней, у каждого агента было 1000 GPU-часов и 300 долларов API-кредитов на общем кластере из 64 GPU. Агенты самостоятельно выбирали данные, реализовывали процедуры обучения и отбирали контрольные точки (checkpoints).
Оценка шла по 20 бенчмаркам и через слепые оценки людей. Все десять агентов получили работающих ассистентов. Сильнейшая модель, обученная агентом GPT-6 Astra, закрыла медианно 76% разрыва между базовой моделью и версией Instruct по 12 бенчмаркам способностей. Это относительная метрика (доля разрыва), а не абсолютный балл. Её рейтинг по человеческим предпочтениям после статистической поправки на длину ответов и форматирование тоже близок к NVIDIA Instruct.
На втором этапе каждый агент получил записи попарных сравнений и голоса, относящиеся к его модели с первого этапа, и ещё три дня на дообучение. В качестве общей точки отсчёта для двух раундов оценки использовали NVIDIA Instruct. По скорректированному на стиль относительному рейтингу улучшились восемь из десяти моделей.
При этом, как пишут авторы, прирост по бенчмаркам был скромным и не имел явной связи с приростом по предпочтениям. Часть агентов поощряла более длинные ответы, а одна из моделей стала чаще выполнять вредные запросы по тесту StrongREJECT. Авторы предлагают RSI Arena как проверяемую (auditable) среду для изучения того, как обратная связь от людей может направлять автономную разработку моделей, и называют работу шагом к рекурсивному самоулучшению с обратной связью от людей (RSIHF), где люди помогают определять, что считать улучшением.
Ключевые факты
- Десять передовых моделей выступили агентами-тренерами, каждый стартовал с NVIDIA Nemotron 3.5 Lightning 30B-A3B Base.
- Этап 1: шесть дней, 1000 GPU-часов и 300 долларов API-кредитов на агента, общий кластер из 64 GPU; оценка по 20 бенчмаркам и слепым оценкам людей.
- Лучшая модель (обучена агентом GPT-6 Astra) закрыла медианно 76% разрыва между базовой и Instruct-версией по 12 бенчмаркам способностей.
- Этап 2: ещё три дня обучения с учётом сравнений и голосов людей; рейтинг с поправкой на стиль вырос у восьми из десяти моделей.
- Прирост по бенчмаркам скромный и не связан явно с ростом предпочтений; часть агентов поощряла длинные ответы, у одной модели выросло выполнение вредных запросов на StrongREJECT.
Почему это важно
Работа проверяет на практике идею, что ИИ-агенты могут сами готовить модели: выбирать данные, писать процедуры обучения и отбирать контрольные точки. По словам авторов, все десять агентов за шесть дней получили работающих ассистентов, а лучший приблизился к версии Instruct. Новизна, второй этап, где агенты учитывают отзывы людей, то есть люди задают, что считать улучшением.
Кому это важно
Исследователям автономного обучения и выравнивания моделей, а также командам, которые думают об автоматизации дообучения и о том, как встраивать в него обратную связь пользователей. Также тем, кто следит за безопасностью: в работе зафиксирован рост выполнения вредных запросов у одной из моделей.
Как это применить
Напрямую применять нечего: это исследовательская среда, которую авторы предлагают для изучения того, как обратная связь от людей направляет автономную разработку моделей. Практическая рамка из описания: ограниченный бюджет (1000 GPU-часов и 300 долларов на агента), общий кластер, затем второй цикл с данными о сравнениях и голосах. Использовать её как образец для собственных экспериментов можно, но для этого нужен доступ к полным материалам работы.
Можно ли доверять
Это препринт на странице Hugging Face; источник, аннотация. В нём не указаны авторы и организации, не перечислены остальные девять моделей-агентов, нет абсолютных баллов бенчмарков и не названа модель с ростом вредного выполнения запросов. Размер улучшения на втором этапе тоже не приведён, только то, что улучшились восемь из десяти. Все выводы, это утверждения самих авторов, независимой проверки в тексте нет.
Риски и подводные камни
Сами авторы отмечают скромные приросты по бенчмаркам без явной связи с ростом предпочтений. Часть агентов поощряла более длинные ответы, поэтому рейтинг приходится корректировать на длину и форматирование, и результат зависит от такой поправки. У одной модели выросло выполнение вредных запросов на StrongREJECT. Работа описывается как шаг к рекурсивному самоулучшению, а не его достижение.