Rollback: роботов учат, откатывая мировую модель к ключевым решениям
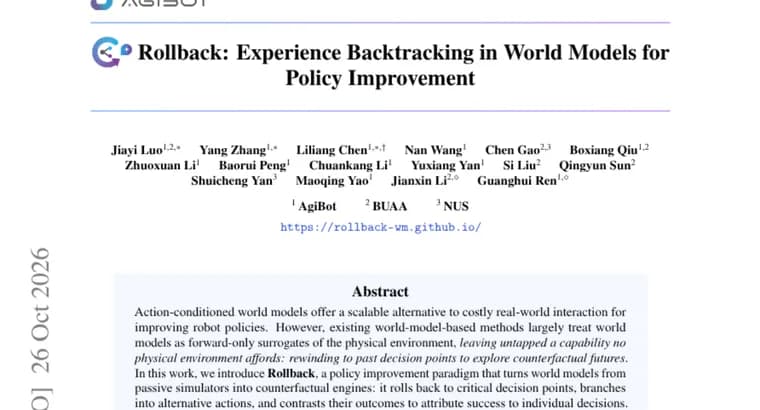
Авторы статьи на Hugging Face Papers исходят из того, что мировые модели (нейросети, предсказывающие, как действие изменит физическую среду) позволяют улучшать стратегии управления роботов без дорогого взаимодействия с реальным миром. Но, по их словам, существующие методы используют такие модели лишь как «заменители» среды, работающие только вперёд. Остаётся неиспользованной возможность, которой нет у физического мира: вернуться к прошлым точкам принятия решений и исследовать контрфактические варианты будущего.
Предложенный подход называется Rollback. Мировая модель из пассивного симулятора превращается в «контрфактический движок»: она откатывается к критическим моментам решения, ветвится на альтернативные действия и сравнивает их исходы, чтобы отнести успех к отдельным решениям. Так воображение концентрируется там, где оно важнее всего, а контрфактические исходы превращаются в детальный надзор на уровне отдельных действий, причём отдельная обучаемая модель ценности не нужна.
Авторы построили масштабируемую обучающую систему, которая объединяет распределённый поиск по мировой модели с асинхронным выполнением на реальном роботе. Получается самоусиливающийся цикл: реальный опыт постоянно уточняет мировую модель, а более точная модель, в свою очередь, ведёт к дальнейшему улучшению стратегии. Мировую часть цикла авторы называют test-time physics grounding (привязка к физике во время работы). По их утверждению, такого свойства нет у физических симуляторов, собранных вручную: пока мировая модель служит средой обучения, реальные переходы, полученные политикой, которую она обучает, корректируют её динамику через облегчённый конвейер LoRA.
Эксперименты проведены на трёх сложных реальных задачах: извлечение блока, подбрасывание мяча и настольный кёрлинг. Rollback превосходит сильнейший базовый метод по доле успехов на абсолютных 10,67%, 11,11% и 11,85% соответственно, при этом улучшение в ходе обучения идёт стабильнее. Обучение начиналось с демонстраций, записанных телеоперацией, уровень которых был далеко ниже человеческого. Тем не менее на подбрасывании мяча и настольном кёрлинге Rollback превзошёл средний показатель успеха людей-игроков менее чем за 8 часов обучения.
Ключевые факты
- Rollback превращает мировую модель из пассивного симулятора в «контрфактический движок»: она откатывается к ключевым решениям, пробует альтернативные действия и сравнивает исходы.
- Контрфактические исходы дают детальный надзор на уровне отдельных действий без отдельно обучаемой модели ценности.
- Реальные переходы робота корректируют динамику мировой модели через облегчённый конвейер LoRA, образуя самоусиливающийся цикл.
- На блоках, подбрасывании мяча и настольном кёрлинге успех выше сильнейшего базового метода на абсолютных 10,67%, 11,11% и 11,85%.
- На подбрасывании мяча и кёрлинге Rollback обгоняет средний показатель людей-игроков менее чем за 8 часов обучения, стартуя с телеоператорских демонстраций.
Почему это важно
Реальные эксперименты с роботами дороги и медленны, поэтому обучение внутри мировых моделей, привлекательная альтернатива. Новизна заявленного подхода в том, что модель используется не только «вперёд», а как инструмент отката и сравнения альтернатив: это даёт оценку вклада отдельных решений. Авторы также отмечают, что при таком подходе не требуется отдельная модель ценности.
Кому это важно
Исследователям робототехники и обучения с подкреплением, а также командам, которые работают с мировыми моделями и ищут способы улучшать стратегии управления при ограниченном числе реальных запусков. Для широкого читателя это пока научный результат, а не готовый продукт.
Как это применить
Из аннотации не следует готового инструмента: в ней не названы ни робот, ни архитектура и размер мировой модели. Практически идея состоит в связке из трёх частей: откат мировой модели к критическим решениям, асинхронный запуск на реальном роботе и периодическая подстройка модели по реальным переходам через LoRA. Для воспроизведения нужно обращаться к полному тексту статьи.
Можно ли доверять
Все утверждения о результатах принадлежат авторам статьи и приведены по аннотации на Hugging Face Papers. В аннотации указаны только абсолютные приросты над сильнейшим базовым методом: сам метод не назван, итоговые доли успеха у Rollback и у базовых методов не приведены. Не указано и то, какой показатель человеческих игроков взят за ориентир, сколько было игроков и как их измеряли. Сравнения с людьми на извлечении блока в аннотации нет. Сведений о независимой проверке или рецензировании нет.
Риски и подводные камни
Результаты получены на трёх конкретных задачах, и перенос на другие задачи и роботов в аннотации не обсуждается. Прирост в 10-12 абсолютных процентов трудно оценить без исходных долей успеха. Сравнение с «средним человеком» зависит от неизвестной методики. Метод опирается на качество мировой модели и на её постоянную коррекцию реальными данными, так что без доступа к реальному роботу цикл не замыкается.
«Rollback превращает мировые модели из пассивных симуляторов в контрфактические движки.»
— из аннотации статьи «Rollback: Experience Backtracking in World Models for Policy Improvement»