RoboArchitect: нейросеть сама проектирует обвязку для роботов без дообучения
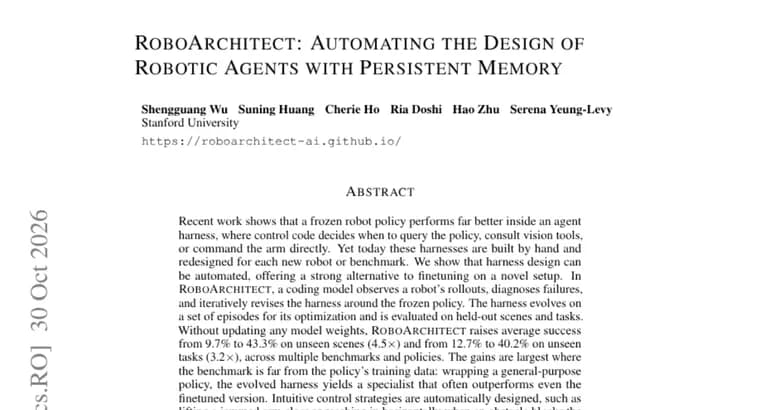
Авторы статьи исходят из того, что замороженная политика робота (то есть модель, чьи веса не меняют) работает заметно лучше, если её поместить в «обвязку» агента (agent harness). Это управляющий код, который решает, когда обращаться к политике, когда подключать инструменты зрения, а когда напрямую командовать манипулятором. Но сегодня такие обвязки пишут вручную и переделывают под каждого нового робота или бенчмарк.
RoboArchitect автоматизирует этот шаг. Кодовая модель смотрит на прогоны робота, диагностирует сбои и шаг за шагом переписывает обвязку вокруг замороженной политики. Обвязка «эволюционирует» на наборе эпизодов, выделенных для оптимизации, а проверяется на отложенных сценах и задачах, которых при настройке не было. Веса моделей при этом не обновляются.
Результаты, о которых сообщают авторы: на незнакомых сценах средний успех вырос с 9,7% до 43,3% (в 4,5 раза), на незнакомых задачах, с 12,7% до 40,2% (в 3,2 раза). Цифры приведены по нескольким бенчмаркам и политикам.
Выигрыш больше всего там, где бенчмарк далёк от обучающих данных политики. Если взять универсальную политику, эволюционировавшая обвязка превращает её в специалиста, который, по словам авторов, часто превосходит даже дообученную версию.
Две особенности. Во-первых, автоматически появляются интуитивные стратегии управления: например, поднять заклинившую руку, чтобы освободить её, или зайти горизонтально, когда сверху путь перекрыт препятствием. Во-вторых, обвязка развивает собственную постоянную память и переносит накопленный опыт, например удачную глубину захвата, в последующие решения.
Вывод авторов: значительный запас улучшений в роботизированной манипуляции лежит в обвязке агента, а её проектирование можно эффективно автоматизировать и оптимизировать без обновления весов.
Ключевые факты
- RoboArchitect: кодовая модель наблюдает за прогонами робота, диагностирует сбои и итеративно переписывает обвязку (управляющий код) вокруг замороженной политики.
- Веса не обновляются: средний успех на незнакомых сценах вырос с 9,7% до 43,3% (в 4,5 раза), на незнакомых задачах, с 12,7% до 40,2% (в 3,2 раза), по нескольким бенчмаркам и политикам.
- Выигрыш наибольший там, где бенчмарк далёк от обучающих данных политики; по словам авторов, обвязка вокруг универсальной политики часто обходит даже дообученную версию.
- Обвязка сама вырабатывает стратегии (поднять заклинившую руку, зайти горизонтально) и ведёт постоянную память с опытом, например с удачной глубиной захвата.
Почему это важно
Работа предлагает альтернативу дообучению при переносе робота на новую обстановку: вместо обновления весов автоматически меняется код вокруг готовой политики. По данным авторов, это поднимает успех в 3-4,5 раза на незнакомых сценах и задачах. Если подход подтвердится, ручная настройка обвязки под каждого робота и бенчмарк станет не нужна.
Кому это важно
Исследователям и инженерам в робототехнике, особенно тем, кто работает с манипуляцией и универсальными политиками, а также тем, кто строит агентные системы вокруг готовых моделей без доступа к их обучению.
Как это применить
Идея в том, чтобы замкнуть цикл: прогнать робота, дать кодовой модели записи прогонов, получить исправленную обвязку и проверить её на отложенных сценах и задачах. В описании статьи нет данных о коде, релизе, затратах вычислений или числе итераций, поэтому оценить готовность к повторению нельзя.
Можно ли доверять
Это препринт, а цифры приведены в аннотации, как заявленные авторами. В описании нет ни названий бенчмарков, политик и кодовой модели, ни числа запусков, ни разбивки на симуляцию и реального робота; не указано и то, как именно считается среднее. Утверждение, что обвязка часто обходит дообученную версию, дано без цифр. Заявленные результаты стоит проверять по полному тексту.
Риски и подводные камни
Выигрыш сильно зависит от того, насколько бенчмарк далёк от обучающих данных политики: там, где он близок, эффект может быть меньше. Средние значения по разным бенчмаркам и политикам могут скрывать большой разброс между отдельными случаями. Низкая исходная точка (9,7% и 12,7%) делает кратный рост заметнее, чем он был бы при сильной базе. Выводы авторов сформулированы осторожно (результаты «указывают»), и это не окончательное доказательство.
«Эти результаты указывают, что значительный запас улучшений в роботизированной манипуляции лежит в обвязке агента, а её проектирование можно эффективно автоматизировать и оптимизировать без обновления весов.»
— Из аннотации статьи о RoboArchitect