RecCAR: новый метод устранил перекос между видео и звуком или движением в генеративных моделях
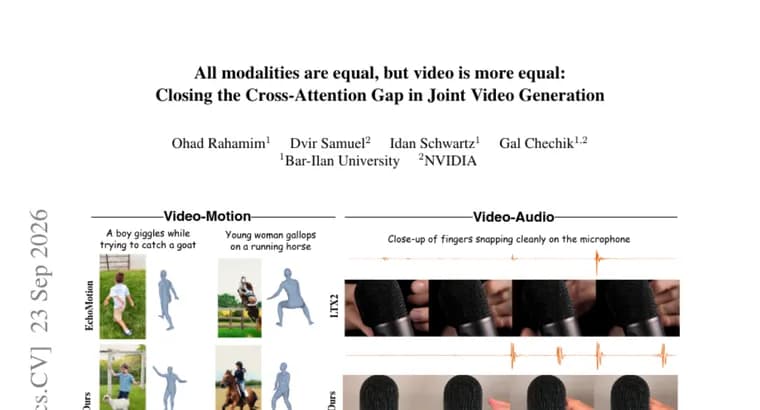
Видео, самая богатая форма представления события: оно одновременно передаёт внешний вид объектов, геометрию сцены, движение и то, как всё это меняется во времени. Другие модальности, такие как 3D-движение тела человека или звук, фиксируют лишь более узкие аспекты того же события. Авторы исследования показали, что в совместных мультимодальных диффузионных трансформерах (моделях, которые генерируют сразу видео и сопутствующую модальность) это различие приводит к перекосу: сопутствующая модальность формирует сильную связь с видео, а вот обратная связь, то, насколько сама сопутствующая модальность влияет на генерацию видео и ограничивает его, оказывается заметно слабее.
Чтобы измерить этот перекос, авторы представили обе связи как сопоставимые распределения соответствия по токенам видео и ввели понятие «разрыва взаимного соответствия», разницы между этими двумя направлениями. Для устранения разрыва предложен метод RecCAR (Reciprocal Cross-modal Attention Regularization, «регуляризация взаимного кросс-модального внимания»), регуляризатор на основе KL-дивергенции, который берёт уже хорошо выраженную связь «видео → модальность» как опорную и подтягивает к ней более слабую связь «модальность → видео».
Метод протестировали на двух задачах совместной генерации: видео с движением тела и видео со звуком. В первом случае RecCAR повысил показатель Human Anatomy (оценку анатомической правдоподобности сгенерированных персонажей) с 0,69 до 0,75. Во втором случае метод снизил рассинхронизацию видео и звука с 0,804 до 0,752. Авторы также сообщают, что RecCAR в целом улучшает качество генерации, но точные цифры этого общего улучшения в доступном фрагменте текста обрываются и не приводятся.
Ключевые факты
- В совместных мультимодальных диффузионных трансформерах видео сильнее влияет на сопутствующие модальности (движение, звук), чем они на него, это назвали разрывом взаимного соответствия
- Авторы предложили RecCAR, KL-регуляризатор, который подтягивает слабую связь «модальность → видео» к уже сильной связи «видео → модальность»
- Метод протестирован на генерации видео с 3D-движением тела и видео со звуком
- Human Anatomy score вырос с 0,69 до 0,75, рассинхронизация видео и звука снизилась с 0,804 до 0,752
- Заявлено также общее улучшение качества генерации, но конкретные цифры этого улучшения в доступном тексте не приведены
Почему это важно
Модели, которые генерируют видео одновременно с движением или звуком, часто страдают от рассинхронизации, персонажи двигаются неестественно или звук не совпадает с картинкой. Работа показывает конкретную техническую причину такого рассогласования, асимметрию кросс-модального внимания, и предлагает измеримое решение, а не общий рецепт.
Кому это важно
Разработчикам и исследователям, создающим генеративные видеомодели с несколькими модальностями: цифровые аватары и анимация с синхронным движением тела, генерация видео со звуковой дорожкой, дубляж и синтез речи с движением губ и телом.
Как это применить
RecCAR, это регуляризатор, добавляемый в процесс обучения совместных диффузионных трансформеров, а не готовый продукт или сервис. Применить его можно, встроив соответствующий KL-регуляризатор в свой пайплайн обучения мультимодальной модели генерации видео; в доступном тексте нет данных о цене, лицензии или готовом коде.
Можно ли доверять
Материал, научная публикация на странице препринтов Hugging Face с конкретными количественными результатами (изменение метрик до и после применения метода), что повышает доверие к заявленным цифрам. При этом в доступном фрагменте не указаны авторы, институты и дата публикации, а также не раскрыты детали архитектуры моделей, датасетов и обучения, эти сведения проверить не удалось.
Риски и подводные камни
Улучшения измерены на узких метриках (оценка анатомической правдоподобности, рассинхронизация звука и видео) и на ограниченном числе задач, движение тела и звук; неизвестно, насколько метод переносится на другие модальности или архитектуры. Заявленное «общее улучшение генерации» не раскрыто конкретными цифрами в доступном тексте, а данных о вычислительных затратах на добавление регуляризатора нет.
«Сопутствующие модальности формируют сильные соответствия с видео, но обратные соответствия, через которые они могли бы ограничивать видео, остаются существенно более слабыми»
— из текста исследования