Qwenputer: в веса Qwen 3.5 4B встроили рабочий RISC-V процессор
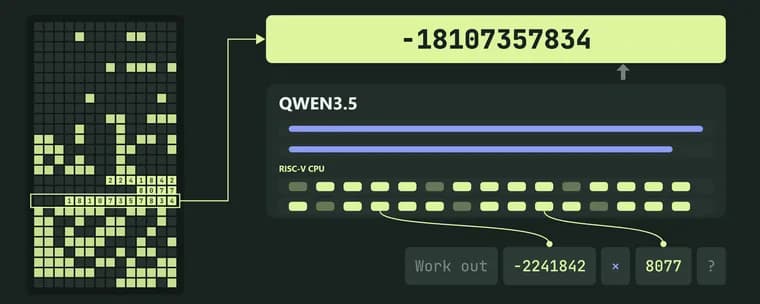
Автор блога Divyansh Agrawal представил Qwenputer: это обычная модель Qwen 3.5 4B с одним дополнением. В её веса встроен 32-битный процессор архитектуры RISC-V, а в роли оперативной памяти у него выступают собственные слои внимания модели Gated DeltaNet (GDN). Процессор работает целиком внутри прямых проходов модели и умеет выполнять арифметику, код на C и MicroPython без внешней среды выполнения и вызова внешних инструментов. Автор подчёркивает: это не плагин, не инструмент и не песочница.
Основная идея. В Qwen3-Next и Qwen 3.5 три слоя внимания из четырёх используют Gated DeltaNet, линейную рекуррентную сеть: каждая голова хранит матрицу состояния, а дельта-правило её обновляет. Автор обнаружил, что если зафиксировать «затвор» (gate) равным 1, силу записи (beta) равной 1 и использовать one-hot ключи, то каждая запись перезаписывает ровно одну строку состояния, а каждый one-hot запрос извлекает точное значение. Так слои GDN работают как точная оперативная память, причём дешевле обычного внимания: состояние головы GDN не растёт с длиной диалога, в отличие от KV-кэша. Идея, что дельта-правило работает как память, не нова: её в 2021 году показали Imanol Schlag, Kazuki Irie и Jürgen Schmidhuber в статье «Linear Transformers Are Secretly Fast Weight Programmers» (ICML 2021). Новизну автор видит в том, чтобы сделать такую память точной и адресуемой внутри промышленной модели, причём достаточно надёжно, чтобы на ней работал целый процессор. В стандартном Qwen 3.5 точные значения в GDN не сохраняются.
Компиляция процессора. Обучения нет: компилятор напрямую задаёт каждый вес. Процессор описывается как схема из мелких шагов («прочитать регистр», «сложить два числа», «перейти, если ноль»), и компилятор превращает каждый шаг в часть слоя трансформера: головы внимания, которые ищут значения, feed-forward блоки, которые считают, и головы DeltaNet, хранящие память. Каждая инструкция превращается в несколько сгенерированных токенов: один называет строку памяти для записи (ADDR), следующий несёт значение (VAL), токен STEP завершает инструкцию. Эти токены и есть трассировка выполнения, то есть пока Qwen их генерирует, процессор реально работает. Исходные веса Qwen остаются без изменений, веса «компьютера» добавлены поверх в дополнительных измерениях и слоях.
Процессор, 32-битное ядро RISC-V (RV32IM плюс расширение Zba и небольшой блок для арифметики с большими числами). Он занимает 11 слоёв перед 32 слоями Qwen. По словам автора, он проходит официальные riscv-tests, его программы совпадают с результатами qemu, а без единой ошибки он выполнил 18 миллионов инструкций в свободном режиме, то есть без эталонной машины, исправляющей шаги. Это ещё не чип уровня Linux, хотя полный набор RV32IM реализован.
Как Qwen его использует. Qwen 3.5 4B использует процессор без дообучения: модель опирается на знакомый ей формат вызова инструментов, отправляет процессору инструкции и читает ответ, но внешних вызовов нет. Небольшой драйвер RvChat загружает прошивку в состояние GDN и не пускает токены трассировки в слои Qwen.
Результаты (по данным автора). На наборах DeepMind: div_big, Qwenputer 97,5% против 95% у Qwen 3.5 4B с инструментом Python и 72,5% у базового Qwen; mul_big, 97,5% против 100% с Python и 55% у базового; mul_div_multiple_longer, 100% против 97,5% с Python и 90% у базового; add_or_sub_big, 97,5% (как и с Python) против 87,5% у базового. На арифметике с длинными целыми из NUPA точность выросла с 48,6% до 100%, как и при выдаче Qwen инструмента Python. Автор сверил около 230 000 выходных позиций с эталонной машиной и не нашёл расхождений. Обычный текст модели остаётся в пределах шума относительно базового Qwen (KL 6e-4 при уровне шума 5e-4).
Файловая система. Поверх памяти автор добавил экспериментальное хранилище файлов с внутренними операциями put, append, get, list и delete, тоже без внешних вызовов. Имя файла хешируется в один из 1024 слотов каталога, который хранится в состоянии DeltaNet; сам текст лежит в других головах по восемь токенов на строку, цепочкой. При коллизии проверяется следующий слот, поиск занимает около двух-трёх шагов. Вмещается до 512 файлов, примерно 53 000 токенов текста. Состояние можно сохранить в конце диалога и загрузить в следующем. С этой файловой системой Qwen правильно отвечает про факты, изменившиеся между диалогами, в 90% случаев против 30%, если вставлять старые диалоги обратно в контекст; это сопоставимо с инструментами памяти, работающими на Python (83,3% против 78,9%). Код этой части лежит в ветке rv-store и пока считается экспериментальным.
Ограничения и планы. Из-за дополнительных слоёв и более широкого скрытого размера чекпоинт весит 18,8 ГБ, примерно вдвое больше базового Qwen, хотя большая часть, нулевое заполнение. Нужен небольшой драйвер RvChat, поэтому с обычным вызовом generate() модель пока не работает. Она медленная: каждая инструкция процессора стоит нескольких декодированных токенов, и большое вычисление занимает секунды, а не миллисекунды; пакетный исполнитель для бенчмарков выдаёт около 3200 токенов процессора в секунду на L4. Модель запускается на одной видеокарте с 24 ГБ памяти. Дальше автор хочет, чтобы Qwen писал Python-код и запускал его на MicroPython внутри собственных весов через инструмент python(), а также ускорить процессор. Автор также называет Qwenputer удобным полигоном для исследований безопасности ИИ и описал два продолжения: как гибридные модели могут научиться прятать рассуждения в состоянии RNN и обходить мониторинг цепочек рассуждений (CoT), и как скомпилированные веса могут служить встроенными средствами мониторинга, которые модель не может отключить. Код выложен на GitHub, модели (Qwenputer и вариант с файловой системой), на Hugging Face и ModelScope.
Ключевые факты
- В веса Qwen 3.5 4B без обучения скомпилирован 32-битный процессор RISC-V (RV32IM, Zba и блок для больших чисел); он занимает 11 слоёв перед 32 слоями Qwen и работает целиком внутри прямых проходов модели.
- Слои Gated DeltaNet превращены в точную память: при gate = 1, beta = 1 и one-hot ключах каждая запись перезаписывает ровно одну строку состояния, а размер состояния не растёт с длиной диалога.
- По данным автора, процессор выполнил 18 миллионов инструкций без ошибок, а на наборах DeepMind и NUPA Qwenputer набирает 97,5-100%, на уровне варианта с инструментом Python и выше базового Qwen (например, 48,6% → 100% на длинных целых).
- Экспериментальная файловая система (1024 слота каталога, до 512 файлов, около 53 000 токенов) даёт 90% верных ответов про изменившиеся факты против 30% при вставке старых диалогов.
- Ограничения: чекпоинт 18,8 ГБ, нужен драйвер RvChat, вычисления занимают секунды, около 3200 токенов процессора в секунду на L4; код и модели открыты.
Почему это важно
Работа показывает, что рекуррентные слои гибридных моделей можно превратить в точную адресуемую память и разместить в весах настоящий процессор, не обучая сеть: каждый вес задаёт компилятор. Сама идея, что дельта-правило работает как ассоциативная память, не нова (Schlag и соавторы, ICML 2021). Автор видит новизну в том, что память стала точной и адресуемой внутри промышленной модели Qwen 3.5. Для задач с длинной точной арифметикой результат наглядный: на NUPA точность выросла с 48,6% до 100%, как при выдаче модели инструмента Python.
Кому это важно
Исследователям архитектур с линейным вниманием и гибридных моделей (Qwen3-Next, Qwen 3.5), тем, кто занимается точными вычислениями внутри нейросетей без внешних инструментов, и специалистам по безопасности ИИ: автор называет Qwenputer полигоном для изучения того, как гибридные модели прячут рассуждения в состоянии RNN, и для встроенных в веса средств мониторинга. Остальным это скорее любопытный эксперимент, чем готовый инструмент.
Как это применить
Автор приводит инструкцию запуска: нужна одна видеокарта на 24 ГБ, менеджер пакетов uv и Hugging Face CLI. Репозиторий клонируется с GitHub (divagr18/qwenputer), модель скачивается с Hugging Face (divagr1925/Qwen3.5-4B-Qwenputer), диалог запускается через модуль chipformer.rv.chat с прошивкой calc-bridge.elf. Внешний сервер инструментов и песочница Python для вычислений не нужны. Обычный вызов generate() пока не поддерживается, требуется драйвер RvChat. Файловая система лежит в ветке rv-store и помечена автором как экспериментальная. Лицензия в тексте не указана.
Можно ли доверять
Все цифры приведены самим автором в личном блоге; в тексте не упомянуты ни независимое воспроизведение, ни рецензирование. Размеры выборок в бенчмарках не названы, поэтому разницу в 2,5 процентного пункта между вариантами оценивать трудно. Сравнение с файловой системой (83,3% против 78,9%) дано без указания, какая цифра чья. С другой стороны, код и модели открыты, так что заявления можно проверить самостоятельно, а автор прямо называет работу экспериментом и перечисляет ограничения.
Риски и подводные камни
Это демонстрация, а не готовое решение: чекпоинт 18,8 ГБ (вдвое больше базового Qwen, большая часть, нули), нужен отдельный драйвер, а каждая инструкция процессора стоит нескольких токенов, поэтому крупные вычисления занимают секунды, а не миллисекунды (около 3200 токенов процессора в секунду на L4). Процессор пока не уровня Linux. Файловая система экспериментальна. Автор также отмечает, что гибридные модели могут научиться прятать рассуждения в состоянии RNN и обходить мониторинг цепочек рассуждений, и этот эксперимент даёт для такого исследования инструмент.
«Чтобы было совсем ясно: это не плагин, не инструмент и не песочница.»
— Divyansh Agrawal, автор Qwenputer