ProgramDistill: бенчмарк проверяет ИИ-агентов на живых веб-приложениях
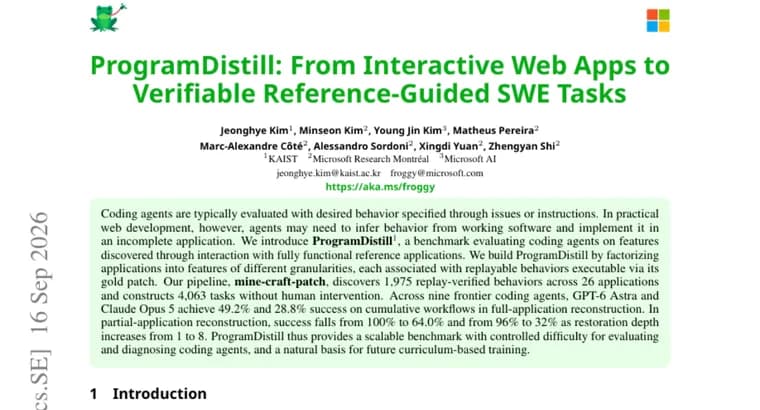
Исследователи представили ProgramDistill, бенчмарк для кодогенерирующих ИИ-агентов, который проверяет не выполнение тикета или инструкции, а способность понять, как должно работать приложение, наблюдая за уже действующей эталонной версией, и воспроизвести это поведение в неполном варианте программы. Авторы отмечают, что именно так часто приходится действовать агентам в реальной веб-разработке: выводить нужное поведение из работающего софта, а не из явного описания задачи.
Бенчмарк построен собственным конвейером mine-craft-patch: он разбивает приложения на функции разной степени детализации, для каждой связывает воспроизводимое поведение с «золотым патчем», который его реализует, и без участия людей извлёк 1 975 проверенных воспроизведением поведений из 26 приложений, собрав из них 4 063 задачи.
На бенчмарке проверили девять топовых кодогенерирующих агентов. На кумулятивных цепочках задач по полному восстановлению приложения лучший результат показал GPT-6 Astra, 49,2% успеха, у Claude Opus 5, 28,8%. При частичном восстановлении приложения успех агентов падает по мере роста «глубины восстановления» (от 1 до 8 шагов): в одной паре показателей, со 100% до 64,0%, в другой, с 96% до 32%; текст не уточняет, какой из результатов относится к какому именно агенту.
Авторы описывают ProgramDistill как масштабируемый бенчмарк с управляемой сложностью для оценки и диагностики кодогенерирующих агентов, а также как основу для будущего обучения по нарастающей сложности задач.
Ключевые факты
- ProgramDistill, бенчмарк, где агент должен угадать поведение приложения по работающей эталонной версии, а не по тикету или инструкции
- Конвейер mine-craft-patch без участия людей извлёк 1 975 воспроизводимых поведений из 26 приложений и собрал из них 4 063 задачи
- На кумулятивных задачах полного восстановления приложения лучший результат у GPT-6 Astra, 49,2% успеха, у Claude Opus 5, 28,8%
- При частичном восстановлении успех падает с ростом глубины восстановления (шаги 1→8): в одной паре, со 100% до 64,0%, в другой, с 96% до 32%
- Проверено девять топовых кодогенерирующих агентов
Почему это важно
Большинство бенчмарков для кодогенерирующих агентов дают модели готовый тикет или инструкцию: что именно нужно реализовать, уже сформулировано словами. ProgramDistill меняет постановку задачи, агенту нужно самому разобраться в поведении, наблюдая за работающим эталонным приложением, и затем воспроизвести это поведение в его неполной версии. Авторы указывают, что именно так часто выглядит реальная веб-разработка: поведение приходится выводить из работающего софта, а не читать в спецификации.
Кому это важно
Бенчмарк адресован разработчикам и исследователям, которые создают, тестируют и сравнивают кодогенерирующих агентов, включая команды, стоящие за агентами вроде GPT-6 Astra и Claude Opus 5, участвовавшими в оценке. Полезен он и тем, кто занимается автоматическим построением обучающих датасетов для агентов: конвейер mine-craft-patch собирает задачи без участия людей.
Как это применить
ProgramDistill можно использовать как диагностический инструмент: результаты по девяти агентам показывают, где именно ломается качество, например, резкое падение успеха при увеличении «глубины восстановления» задачи. Авторы также предлагают бенчмарк как основу для curriculum-обучения, постепенного наращивания сложности задач при тренировке агентов.
Можно ли доверять
Методология описана достаточно подробно и проверяема: 26 эталонных приложений, 1 975 поведений, верифицированных через воспроизведение (replay), 4 063 задачи, привязанные к «золотым патчам», то есть к эталонным изменениям кода, реализующим нужное поведение. Оценка проведена сразу на девяти топовых агентах. Из текста, впрочем, не видно ни имён авторов или организации, ни даты публикации и площадки, ни сравнения с прежними бенчмарками, это данные, которые доступны в самой статье, но не приведены в описании.
Риски и подводные камни
Ключевой результат бенчмарка сам по себе тревожный сигнал: успех агентов резко падает по мере роста сложности задачи, от 100% и 96% на минимальной глубине восстановления до 64,0% и 32% на максимальной. Это говорит о хрупкости агентов на длинных цепочках работы с кодом, а не только о частных недоработках. Кроме того, из текста не следует, какая пара показателей относится к какому агенту, сопоставление доступно только по порядку упоминания, а не поимённо.