Признаки разреженных автокодировщиков лишь частично складываются аддитивно
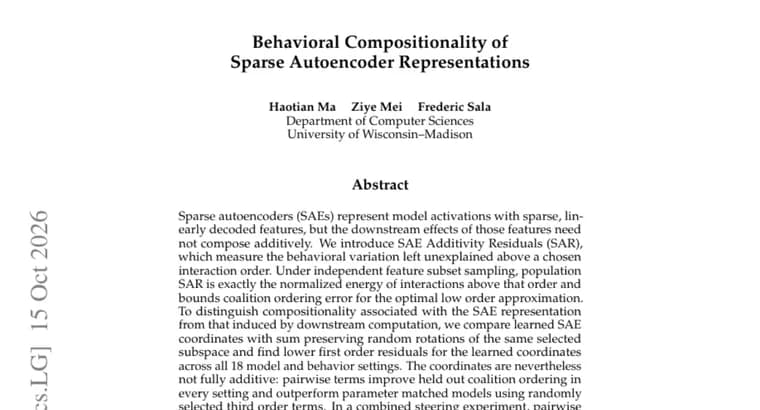
Разреженные автокодировщики (SAE) представляют активации модели через разреженные, линейно декодируемые признаки. Но то, как эти признаки влияют на поведение модели дальше, не обязано складываться аддитивно: эффект двух признаков вместе может не равняться сумме их эффектов по отдельности.
Авторы работы вводят меру SAE Additivity Residuals (SAR), «остатки аддитивности SAE». Она показывает, какая часть вариации поведения остаётся необъяснённой выше выбранного порядка взаимодействий. Согласно аннотации, при независимой выборке подмножеств признаков популяционный SAR в точности равен нормированной энергии взаимодействий выше этого порядка и ограничивает ошибку упорядочивания коалиций (наборов признаков) для оптимального приближения низкого порядка.
Чтобы отделить композиционность, связанную именно с SAE-представлением, от композиционности, которую создаёт последующее вычисление в модели, авторы сравнивают выученные SAE-координаты со случайными поворотами того же выбранного подпространства, сохраняющими сумму. Результат: у выученных координат остатки первого порядка ниже во всех 18 настройках «модель плюс поведение».
Тем не менее координаты не полностью аддитивны. Парные члены улучшают упорядочивание коалиций на отложенных данных в каждой настройке и превосходят модели с тем же числом параметров, в которых вместо парных членов использованы случайно выбранные члены третьего порядка.
В комбинированном эксперименте со стирингом (направленным управлением поведением модели через признаки) парное моделирование поднимает ранговую точность (rank fidelity) с 0,5874 до 0,7790 и снижает ошибку упорядочивания с 0,1444 до 0,0606.
Итог, по словам авторов: SAE-координаты допускают сравнительно композиционные описания поведения, однако для достоверных совместных объяснений и вмешательств по-прежнему нужны взаимодействия, выходящие за рамки эффектов отдельных признаков. Код опубликован в репозитории OpenSAE/SAE-Behavioral-Compositionality на GitHub.
Ключевые факты
- Введена мера SAR (SAE Additivity Residuals): она оценивает долю поведенческой вариации, не объяснённую взаимодействиями выше выбранного порядка.
- Выученные SAE-координаты дают более низкие остатки первого порядка, чем сохраняющие сумму случайные повороты того же подпространства, во всех 18 настройках «модель плюс поведение».
- Полной аддитивности нет: парные члены улучшают упорядочивание коалиций признаков в каждой настройке и обходят модели с тем же числом параметров на случайных членах третьего порядка.
- В комбинированном эксперименте со стирингом парное моделирование поднимает ранговую точность с 0,5874 до 0,7790 и снижает ошибку упорядочивания с 0,1444 до 0,0606.
- Код работы доступен на GitHub (OpenSAE/SAE-Behavioral-Compositionality).
Почему это важно
Разреженные автокодировщики, один из основных инструментов интерпретации нейросетей: они разлагают активации на отдельные признаки. Частое негласное допущение, что эффект набора признаков можно понять как сумму эффектов каждого. Работа проверяет это допущение количественно и показывает, что оно выполняется лишь отчасти: SAE-признаки заметно аддитивнее случайных осей, но взаимодействия между ними всё равно существенны.
Кому это важно
В первую очередь исследователям интерпретируемости и тем, кто использует SAE для объяснения поведения моделей или для управления им через признаки (стиринг). Для широкой аудитории тема нишевая: речь о методологии анализа, а не о новом продукте или модели.
Как это применить
Практический вывод из аннотации: при описании совместного эффекта нескольких SAE-признаков или при вмешательствах через них стоит учитывать как минимум парные взаимодействия, а не ограничиваться суммой индивидуальных эффектов. Меру SAR можно использовать, чтобы оценить, сколько вариации остаётся необъяснённым при выбранном порядке модели. Код опубликован на GitHub по адресу OpenSAE/SAE-Behavioral-Compositionality.
Можно ли доверять
Это текст аннотации статьи на Hugging Face; полной версии работы в материале нет. Все выводы, заявления самих авторов. Аннотация не называет конкретные модели, SAE и поведения, входящие в 18 настроек, не раскрывает величину разрыва в остатках первого порядка между выученными координатами и случайными поворотами и не поясняет, что именно служит исходным уровнем в эксперименте со стирингом. Данных о проверке на производственных или передовых моделях в аннотации нет.
Риски и подводные камни
Результаты получены в 18 конкретных настройках, и переносить их на другие модели и SAE без проверки нельзя. Вывод о «сравнительной» композиционности относителен: он опирается на сравнение со случайными поворотами и не означает, что признаки независимы. Улучшение при парном моделировании показано в комбинированном эксперименте со стирингом; за его пределами числа в аннотации не приведены. Парные члены усложняют объяснения, и сам факт взаимодействий означает, что описание по одному признаку может вводить в заблуждение.
«Эти результаты показывают, что SAE-координаты поддерживают сравнительно композиционные описания поведения, тогда как достоверные совместные объяснения и вмешательства по-прежнему требуют взаимодействий, выходящих за рамки эффектов отдельных признаков.»
— из аннотации статьи