Представлена MJev-Spatial: ИИ отвечает о пространстве без генерации текста
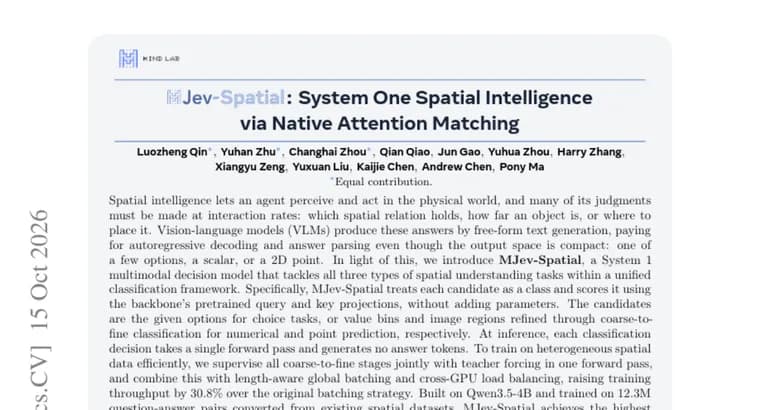
Авторы препринта с Hugging Face исходят из того, что пространственный интеллект, способность воспринимать физический мир и действовать в нём, требует ответов в темпе взаимодействия: какое пространственное отношение выполняется, как далеко находится объект, куда его поместить. Обычные визуально-языковые модели (VLM) выдают такие ответы свободным текстом, расплачиваясь авторегрессионным декодированием и разбором ответа, хотя пространство возможных ответов компактно: один из нескольких вариантов, число или точка на плоскости.
В ответ авторы представляют MJev-Spatial, мультимодальную модель принятия решений типа System 1 (быстрых решений), которая решает все три типа задач на понимание пространства в единой классификационной схеме. Каждый кандидат трактуется как класс и оценивается с помощью предобученных проекций query и key самой базовой модели, без добавления параметров. Кандидаты, это заданные варианты в задачах выбора, а для числовых ответов и предсказания точек, интервалы значений и области изображения, которые уточняются классификацией от грубого к точному. При выводе каждое классификационное решение занимает один прямой проход и не порождает токенов ответа.
Для эффективного обучения на разнородных пространственных данных все стадии «от грубого к точному» обучаются совместно с teacher forcing в одном прямом проходе. В сочетании с глобальным батчингом с учётом длины последовательностей и балансировкой нагрузки между GPU это, по данным авторов, подняло пропускную способность обучения на 30,8% по сравнению с исходной стратегией батчинга.
Модель построена на Qwen3.5-4B и обучена на 12,3 млн пар «вопрос, ответ», преобразованных из существующих пространственных датасетов. По заявлению авторов, MJev-Spatial показывает наивысший общий результат (65,64%) среди восьми протестированных моделей, занимает первое место на семи из двенадцати бенчмарков и превосходит свою неизменённую авторегрессионную базовую модель на всех двенадцати. При этом она работает в 2,5 раза быстрее самого быстрого авторегрессионного baseline-варианта и в 5,6 раза быстрее базовой модели.
Ключевые факты
- MJev-Spatial решает три типа пространственных задач (выбор, число, точка) как классификацию: кандидаты оцениваются предобученными проекциями query и key базовой модели, параметры не добавляются.
- При выводе каждое решение, один прямой проход, токены ответа не генерируются; числа и точки уточняются классификацией от грубого к точному.
- Построена на Qwen3.5-4B, обучена на 12,3 млн пар «вопрос, ответ», конвертированных из существующих пространственных датасетов.
- Общий результат 65,64%, наивысший среди восьми протестированных моделей; первое место на семи из двенадцати бенчмарков, выигрыш у базовой модели на всех двенадцати.
- Скорость: в 2,5 раза выше самого быстрого авторегрессионного baseline-варианта и в 5,6 раза выше базовой модели; пропускная способность обучения выросла на 30,8%.
Почему это важно
Идея в том, чтобы не заставлять модель «писать» ответ там, где пространство ответов небольшое и известно заранее: один из вариантов, число или точка. Если классификация за один прямой проход даёт качество не хуже авторегрессионной генерации, это снимает затраты на декодирование и разбор текста, а именно они, по словам авторов, мешают отвечать в темпе взаимодействия. Заявленный выигрыш в скорости, в 2,5 раза против самого быстрого авторегрессионного варианта и в 5,6 раза против базовой модели.
Кому это важно
Исследователям визуально-языковых моделей и пространственного понимания, а также тем, кто строит системы, где решения о положении, расстоянии и размещении объектов нужно принимать быстро (авторы говорят о восприятии и действии в физическом мире). Интересен и сам приём, использовать предобученные проекции query и key как классификатор без новых параметров.
Как это применить
Напрямую, пока никак: в тексте источника нет сведений о выпуске кода, весов или лицензии. Практически применимы идеи из описания метода: трактовать кандидатов как классы, уточнять числовые и координатные ответы от грубого к точному, обучать все стадии совместно с teacher forcing в одном проходе, а для ускорения обучения применять батчинг с учётом длины и балансировку нагрузки между GPU.
Можно ли доверять
Это препринт, и все цифры, заявления самих авторов. В тексте не названы ни восемь сравниваемых моделей, ни двенадцать бенчмарков, ни авторегрессионные baseline-варианты, а 65,64% описан лишь как общий результат без указания метрики и способа агрегации. Не приведены абсолютные задержки и оборудование для замеров 2,5× и 5,6×, а также результаты базовой модели и других участников, поэтому величина отрыва неизвестна. Названия авторов и организаций в тексте нет.
Риски и подводные камни
Подход рассчитан на задачи с компактным пространством ответов: варианты, число или точка. Для открытых текстовых ответов он, судя по описанию, не предназначен. Скорость указана в относительных величинах без условий замера, поэтому перенос на своё оборудование предсказать нельзя. Неясно также, за счёт чего именно выросла пропускная способность обучения на 30,8%: только батчинга или и совместного обучения стадий тоже. Независимой проверки результатов в источнике нет.